

前回、Cloudflare AI Searchでサイト内検索を実装した話を書きましたが、今回はその続編です。
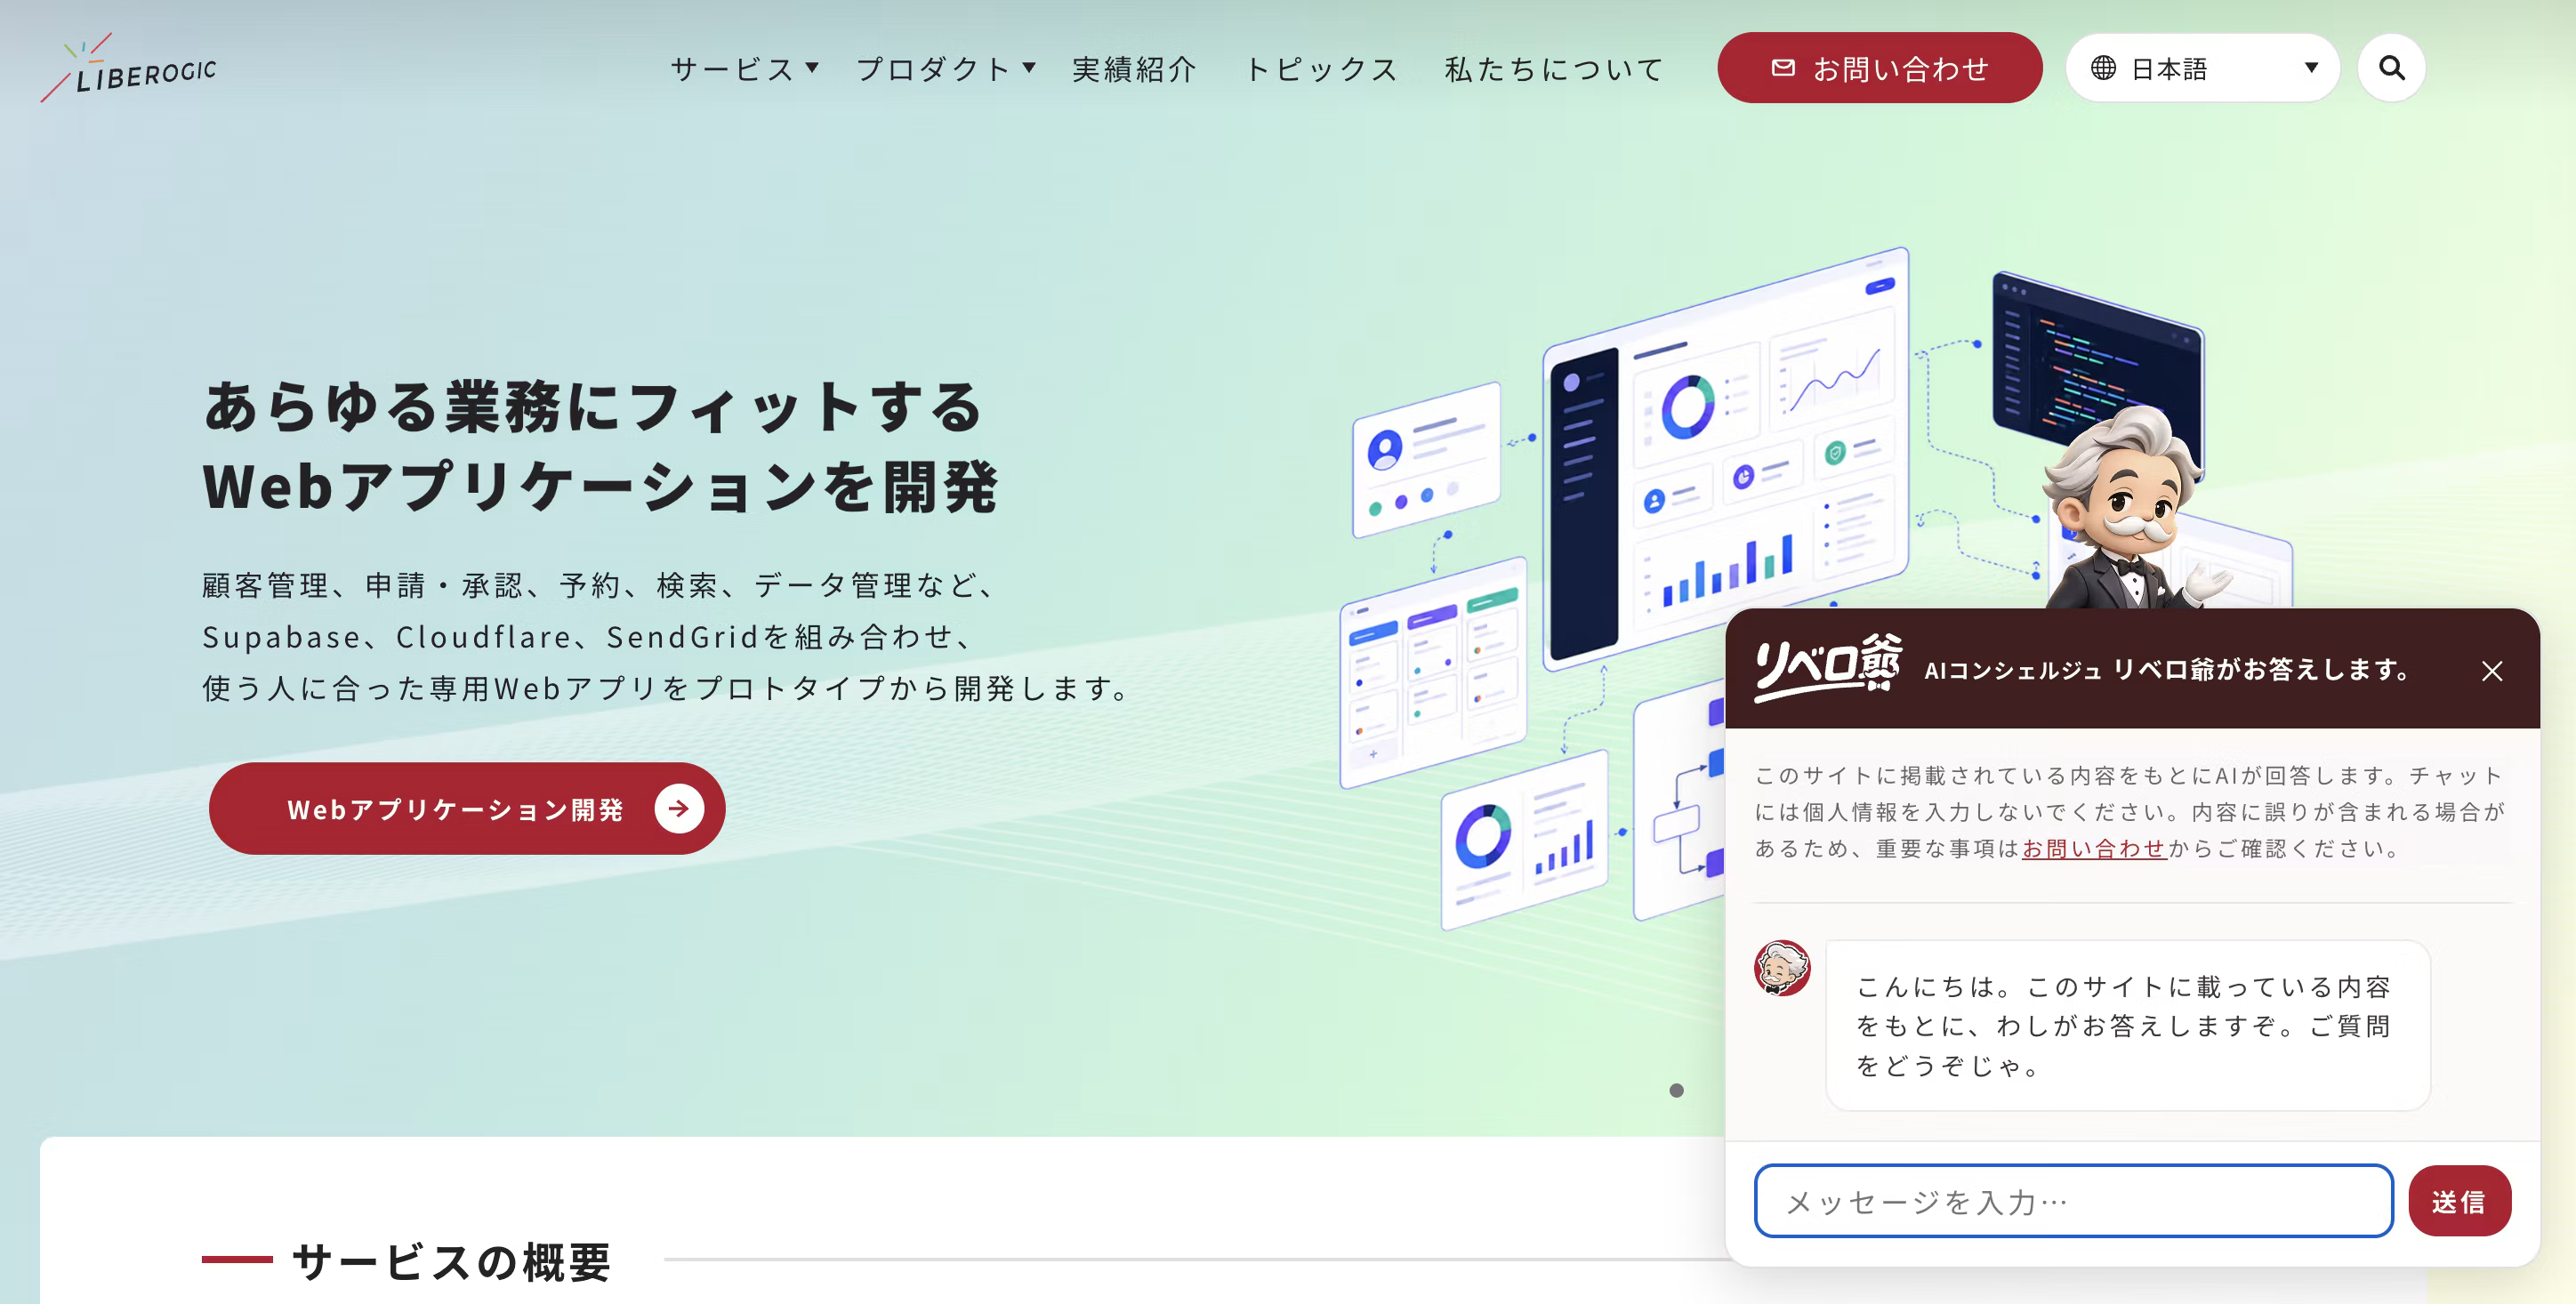
同じAI Searchを使って、サイトの内容をもとに回答するチャットボット「AIコンシェルジュ リベロ爺」を実装しました。
結論から言うと、検索を導入済みなら追加コストはかなり小さいです。
クロール〜インデックスの仕組みはそのまま流用でき、データの追加準備はゼロ。
作業の中心はコードよりプロンプトのチューニングでした。
使うのは chat/completions
前回書いたとおりAI SearchのAPIは2系統あります。
検索結果一覧を返す search と、RAGで回答を生成する chat/completions。
サイト内検索では前者だけを使いましたが今回は後者です。
chat/completions は「クエリの埋め込み → インデックスから関連チャンクを検索 → チャンクを根拠にLLMが回答を生成」までを 1 リクエストでやってくれます。
検索とチャットで同じインデックスを共用できるので、ページを更新すれば両方に反映されます。
構成:APIルート1本 + チャットUI1つ
構成も前回と同じ発想でAPIトークンをブラウザに出せないのでAstroのAPI ルート(Pages Functions)でプロキシします。
const res = await fetch(
  `https://api.cloudflare.com/client/v4/accounts/${id}/ai-search/instances/${name}/chat/completions`,
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}` },
    body: JSON.stringify({
      messages: [{ role: 'system', content: SYSTEM_PROMPT }, ...history],
      stream: false,
      ai_search_options: {
        retrieval: {
          retrieval_type: 'hybrid',
          max_num_results: 8, // 根拠として渡すチャンク数。増やすほど入力トークン=費用が増える
          filters: { locale: 'ja_JP' }, // チャットは日本語限定
        },
      },
    }),
  }
);
フロントは右下フローティングのチャットUIコンポーネントを1つで、会話履歴は表示用のDOMとは別に配列で持ちAPIに送るのは直近10発言・1発言200字までに制限しています。
履歴は毎回まるごと入力トークンになるので、ここを絞るのがコスト管理の勘所です。
システムプロンプトはコードで管理
回答方針はダッシュボードの「システムプロンプト」でも設定できますが、コード側で渡す方式にしました。レビューと変更履歴がGitに残るからです。
方針はこんな感じです。
- 提供された参考情報だけを根拠に回答する
- 根拠がなく答えられない場合(料金の詳細、納期など)は、推測せずお問い合わせフォームへ誘導する
- 3〜4文で簡潔に。回答できた場合に「サイトには記載がない」などの断り書きを付け足さない
ハルシネーション対策は「出典の常時表示」
レスポンスには回答と一緒に、根拠として使われたチャンクが返ってきます。これをURL単位に集約して、回答の下に「参照したページ」として必ず表示するようにしました。ユーザーが一次情報にすぐ当たれるので、AIの回答を鵜呑みにさせない設計です。
多言語サイトではチャットは日本語限定に
前回、検索では locale メタデータの filters で表示言語に絞る話を書きました。チャットも同じフィルタで日本語ページだけを根拠にしています。
さらにUI自体も日本語ページ限定にしました。回答品質を担保できる言語だけに提供を絞る判断です。
アクセシビリティ
チャットUIは動的に発言が増えていくUIなので、支援技術対応は最初から組み込みました。
- ログ領域は
role="log"+aria-live="polite"で、新しい発言だけが読み上げられるように - 発言者の区別は見た目(吹き出しの色・位置)だけでなく、読み上げ専用の「あなた:」「AI:」ラベルを併置
- Escで閉じてトグルボタンへフォーカスを戻す、開いたら入力欄へフォーカス
コストはAI Gatewayで質問単位に見える
AI Searchの裏側の呼び出しはAI Gatewayのログで観測できます。1質問 = 「クエリの埋め込み(bge-m3、$0.0000001台)」+「回答の生成(生成モデル)」の2行。生成モデルのログ件数がそのまま質問数になるので、利用状況の把握も簡単です。
ちなみにログにはbge-m3の行が他にも大量に出ますが、それはクロール時のインデックス更新です。料金が1桁大きいバッチなのですぐ見分けられます。
過度な期待は禁物:知識はサイトの中身だけ、賢さはモデル次第
今はサイトに公開している内容しか読んでいないので、答えられる範囲は広くありません。AI SearchはR2バケットもデータソースにできるため、たとえば過去の提案書などをドキュメント化して知識として持たせる拡張は可能です。
また「サイトの内容しか話さない=嘘をつかない」ではありません。断片の誤読や複数ページの混同で、書いていないことをもっともらしく語ることはあり得ます。出典を常時表示しているのはこの保険です。
もうひとつ、生成しているのはWorkers AI上で動くMetaの安価なオープンモデル(Llama系)で、賢さは最新の商用モデルにはっきり劣ります。より精度を求めるならコスト増と引き換えにモデルを差し替える、が現実的です。
まとめ
サイト内検索でAI Searchを導入済みなら、チャットボットの追加は「APIルート1本 + UI1つ + プロンプト」で済みます。データの二重管理がないのが最大の利点で、ページを更新すれば検索もチャットも同じように賢くなります。
一方で、回答品質は生成モデルとプロンプト次第です。キャラ付けや回答方針は実際のログを見ながら地道に調整する前提でいたほうがよく、「入れて終わり」にはなりません。そこも含めて、自社サイト規模のRAGチャットとしてはかなり手軽な選択肢だと思います。






DTPからWebの世界へ飛び込み、気づけばマークアップもフロントエンドもディレクションもアクセシビリティもこなす"技の仙人"。リベロジック創業期からマルチに活躍し、今や社内の生き字引的存在。最近は「アクセシビリティ対応、もっとAIに頼れないかな?」と、プロンプトを駆使した効率化の探究にハマり中。技術も思考も、まだまだ進化中
二俣 歩
IAAP認定ウェブアクセシビリティスペシャリスト(WAS) / マークアップエンジニア / フロントエンドエンジニア / ウェブディレクター