

上一篇文章介绍了如何使用 Cloudflare AI Search 实现站内搜索,本篇是其续篇。
我们使用同一个 AI Search,基于网站内容实现了能够作答的聊天机器人“AI 礼宾员 Liberozee”。
结论先说,如果已经引入了搜索功能,额外成本会非常低。
爬取到建立索引的机制可以直接复用,数据的额外准备工作为零。
工作的重点与其说是代码,不如说是提示词(Prompt)的调优。
使用的是 chat/completions
如上一篇所述,AI Search 的 API 分为两类。
一类是返回搜索结果列表的 search,另一类是通过 RAG 生成回答的 chat/completions。
站内搜索只用了前者,而这次用的是后者。
chat/completions 可以在一次请求中完成以下全部流程:“查询向量化 → 从索引中检索相关分块 → 以分块为依据由 LLM 生成回答”。
搜索与聊天可以共用同一个索引,因此只要更新页面,两者都会同步生效。
架构:API 路由 1 个 + 聊天 UI 1 个
架构思路也与上次相同:由于不能将 API 令牌暴露到浏览器中,因此通过 Astro 的 API 路由(Pages Functions)进行代理。
const res = await fetch(
  `https://api.cloudflare.com/client/v4/accounts/${id}/ai-search/instances/${name}/chat/completions`,
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}` },
    body: JSON.stringify({
      messages: [{ role: 'system', content: SYSTEM_PROMPT }, ...history],
      stream: false,
      ai_search_options: {
        retrieval: {
          retrieval_type: 'hybrid',
          max_num_results: 8, // 根拠として渡すチャンク数。増やすほど入力トークン=費用が増える
          filters: { locale: 'ja_JP' }, // チャットは日本語限定
        },
      },
    }),
  }
);
前端只有一个位于右下角的浮动聊天 UI 组件。会话历史与用于显示的 DOM 分开,以数组形式保存,发送给 API 时限定为最近 10 条消息,且每条消息不超过 200 个字符。
历史记录每次都会全部计为输入 token,因此控制这部分是成本管理的关键。
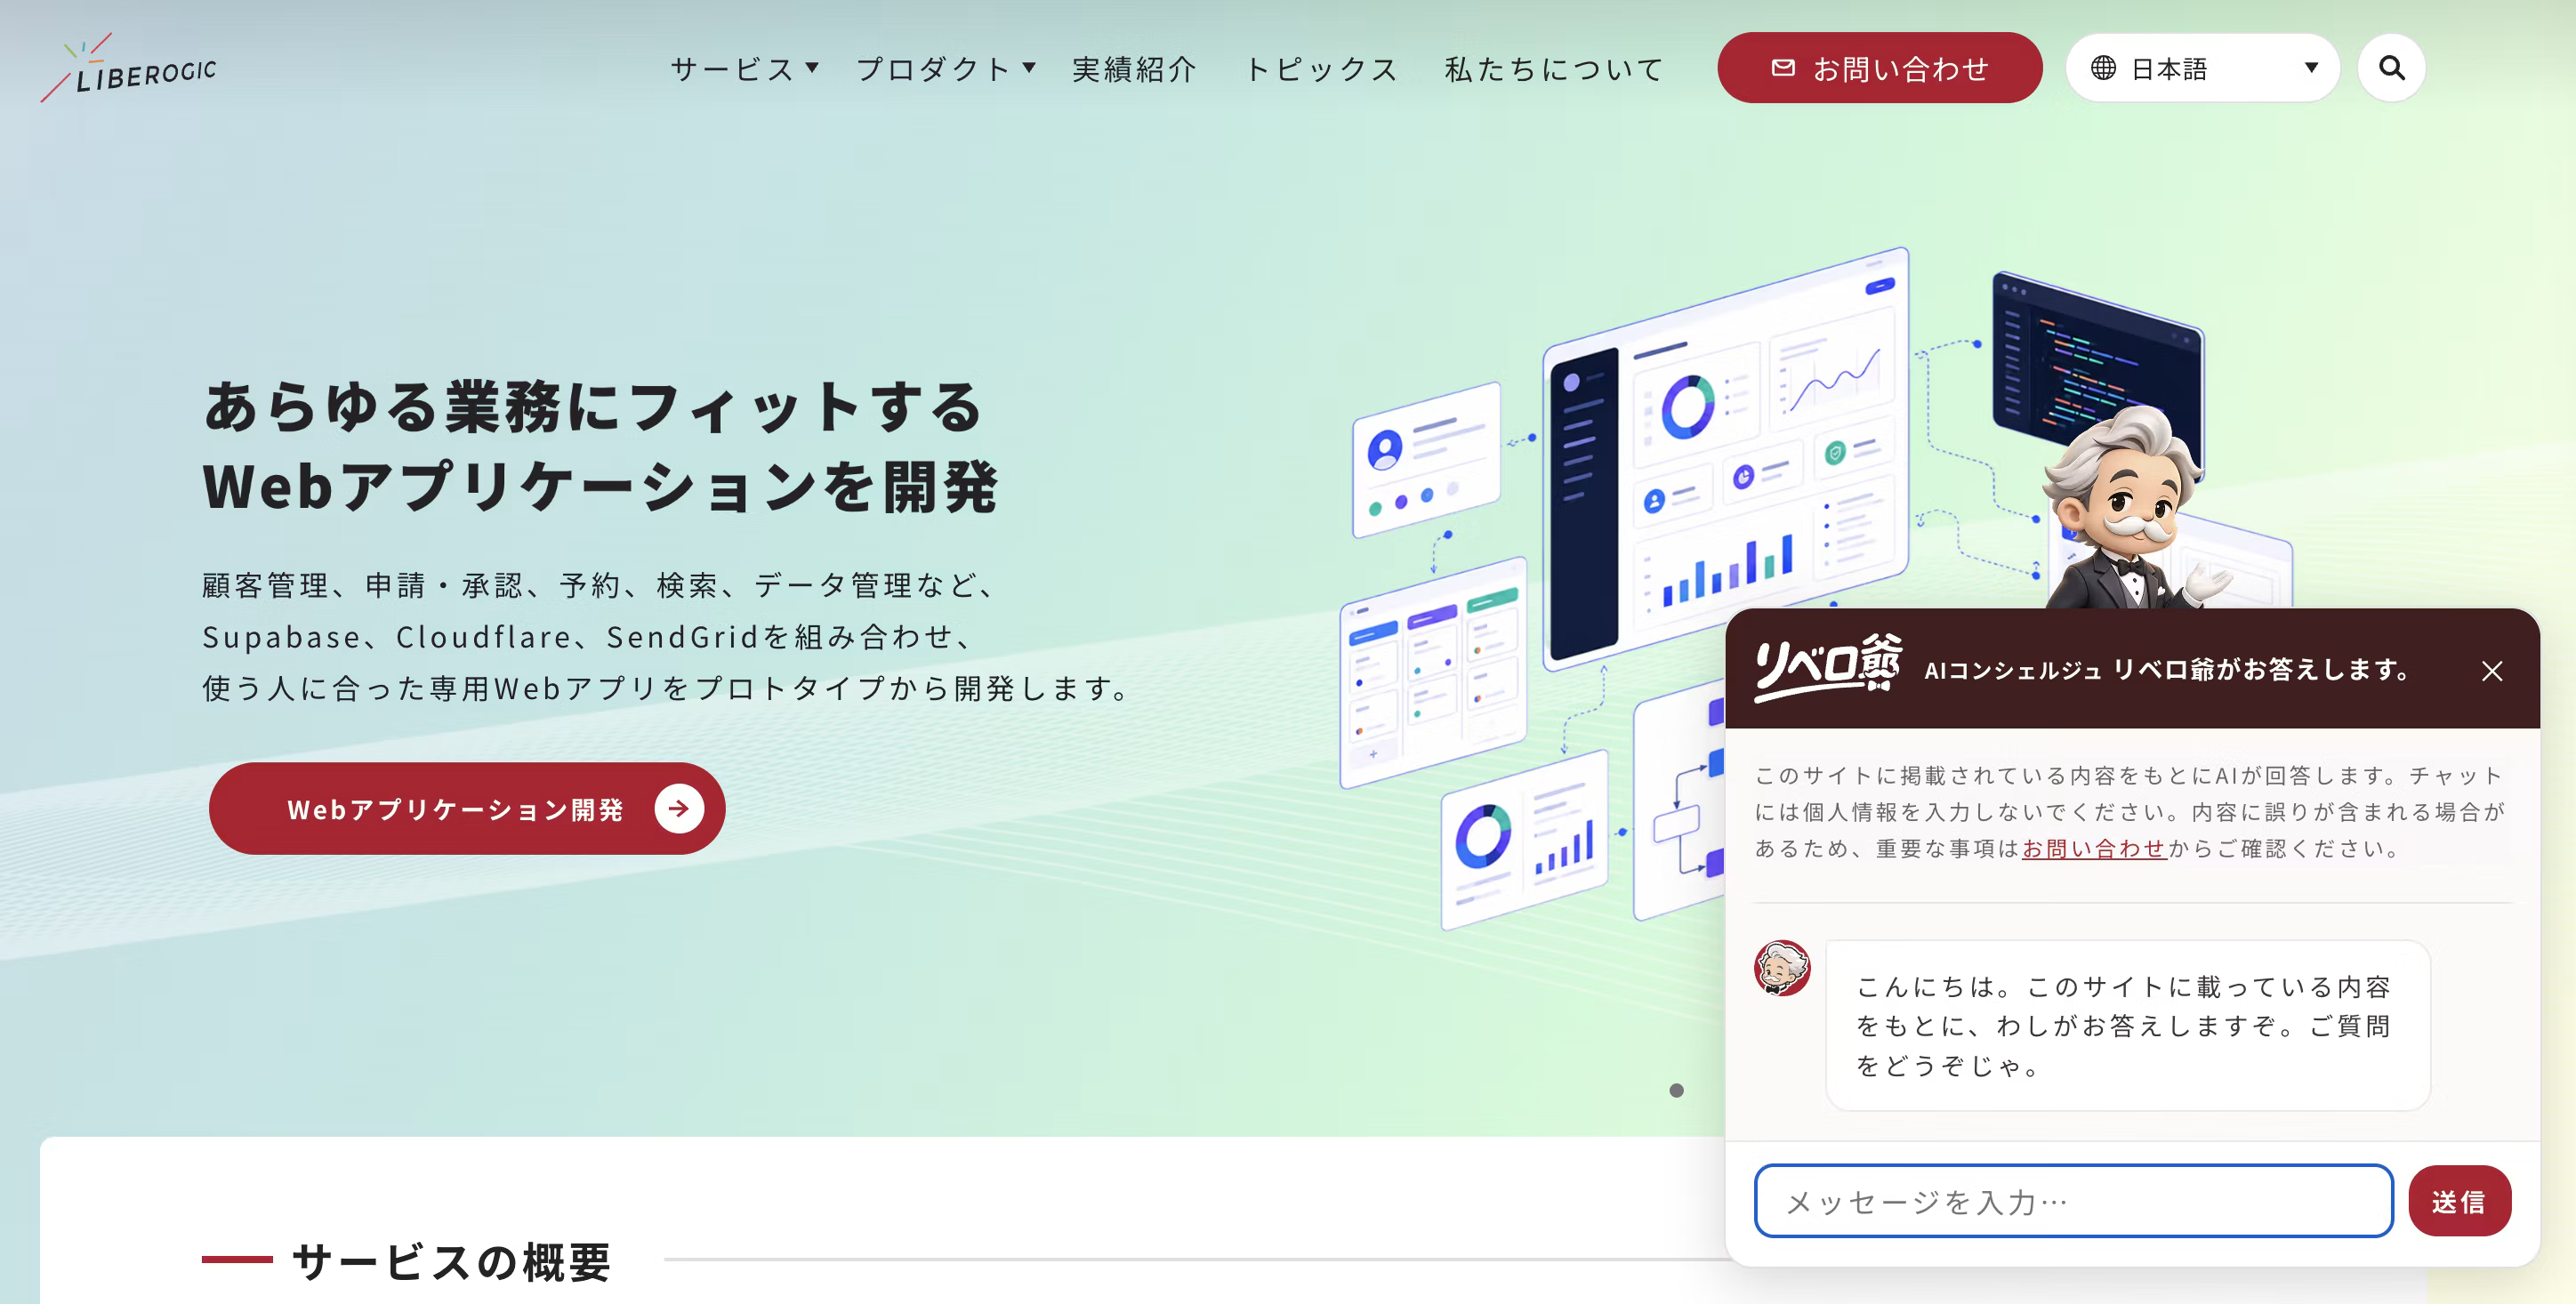
系统提示词在代码中管理
虽然也可以在仪表板的“系统提示词”中设置回答策略,但我们选择了在代码中传递。这是因为审查记录和变更历史都会保留在 Git 中。
方针大致如下。
- 仅以提供的参考信息作为依据进行回答
- 若没有依据而无法作答(如价格详情、交付周期等),则不作推测,引导用户前往咨询表单。
- 用3至4句话简明回答。能够作答时,不要额外添加“网站中未记载”等免责说明。
应对幻觉的方法是“始终显示出处”。
响应中会与回答一同返回作为依据使用的文本块。我们将其按URL汇总,并在回答下方始终以“参考页面”的形式显示。用户可以立即查阅一手信息,因此该设计不会让用户盲目采信AI的回答。
多语言网站中,聊天功能仅限日语
上次我们介绍了在搜索中通过 locale 元数据的 filters 将显示语言限定为特定语言。聊天功能同样使用该过滤器,仅以日语页面作为依据。
此外,我们还将界面本身限定为日语页面。我们的判断是只向能够保证回答质量的语言提供该功能。
无障碍
聊天界面会随着发言不断增加而动态更新,因此从一开始就内置了辅助技术支持。
- 日志区域使用
role="log"+aria-live="polite",只朗读新增的发言。 - 发言者的区分不仅依靠视觉样式(气泡颜色、位置),还并列添加了仅供朗读的“你:”“AI:”标签。
- 按 Esc 关闭后,焦点返回切换按钮;打开时,焦点移至输入框。
费用可通过 AI Gateway 按提问逐条查看。
AI Search 背后的调用可以通过 AI Gateway 的日志进行观察。1 次提问 = 「查询的嵌入(bge-m3,约 $0.0000001)」+「回答的生成(生成模型)」共 2 行。生成模型的日志条数即为提问次数,因此也很容易掌握使用情况。
顺便一提,日志中还会大量出现 bge-m3 的其他记录,那是爬取时的索引更新。由于其费用高出一个数量级,很容易辨别。
切勿过度期待:知识仅限于网站内容,智能程度取决于模型
目前它只读取了网站上公开的内容,因此能够回答的范围并不广。AI Search 还可以把 R2 存储桶作为数据源,例如将过去的提案书等整理成文档作为知识加以扩展,这是可行的。
另外,“只谈网站内容 = 不会撒谎”并不成立。因片段被误读或混淆多个页面,也可能煞有介事地谈论并未写明的内容。始终显示出处正是为了防范这一点。
另外,我们使用的是Workers AI上运行的Meta低成本开源模型(Llama系列),其能力明显不及最新的商用模型。若想追求更高精度,较现实的做法是更换模型,但会增加成本。
总结
如果网站内搜索已经引入了AI Search,那么添加聊天机器人只需要“1条API路由 + 1个UI + 提示词”即可完成。最大的优点是无需重复管理数据,只要更新页面,搜索和聊天都会同样变得更智能。
另一方面,回答质量取决于生成模型和提示词。角色设定和回答策略需要结合实际对话记录,持续细致地调整,因此不能“装上就完事”。综合来看,对于企业自有网站规模的RAG聊天功能而言,这是相当轻松的选择。




从 DTP 进入 Web 领域,不知不觉间,标记、前端、项目指导、无障碍样样精通的“技术仙人”。自 Liberogic 创业初期起就身兼多职,如今已是公司内的活字典般的存在。最近沉迷于用提示词提升效率的探索:“无障碍支持,能不能更多地依靠 AI 呢?”技术与思考仍在不断进化中。
二俣 歩
IAAP认证网页无障碍专家(WAS) / 标记工程师 / 前端工程师 / 网页总监