

En la entrada anterior explicamos cómo implementar la búsqueda dentro del sitio con Cloudflare AI Search. Esta vez presentamos la continuación.
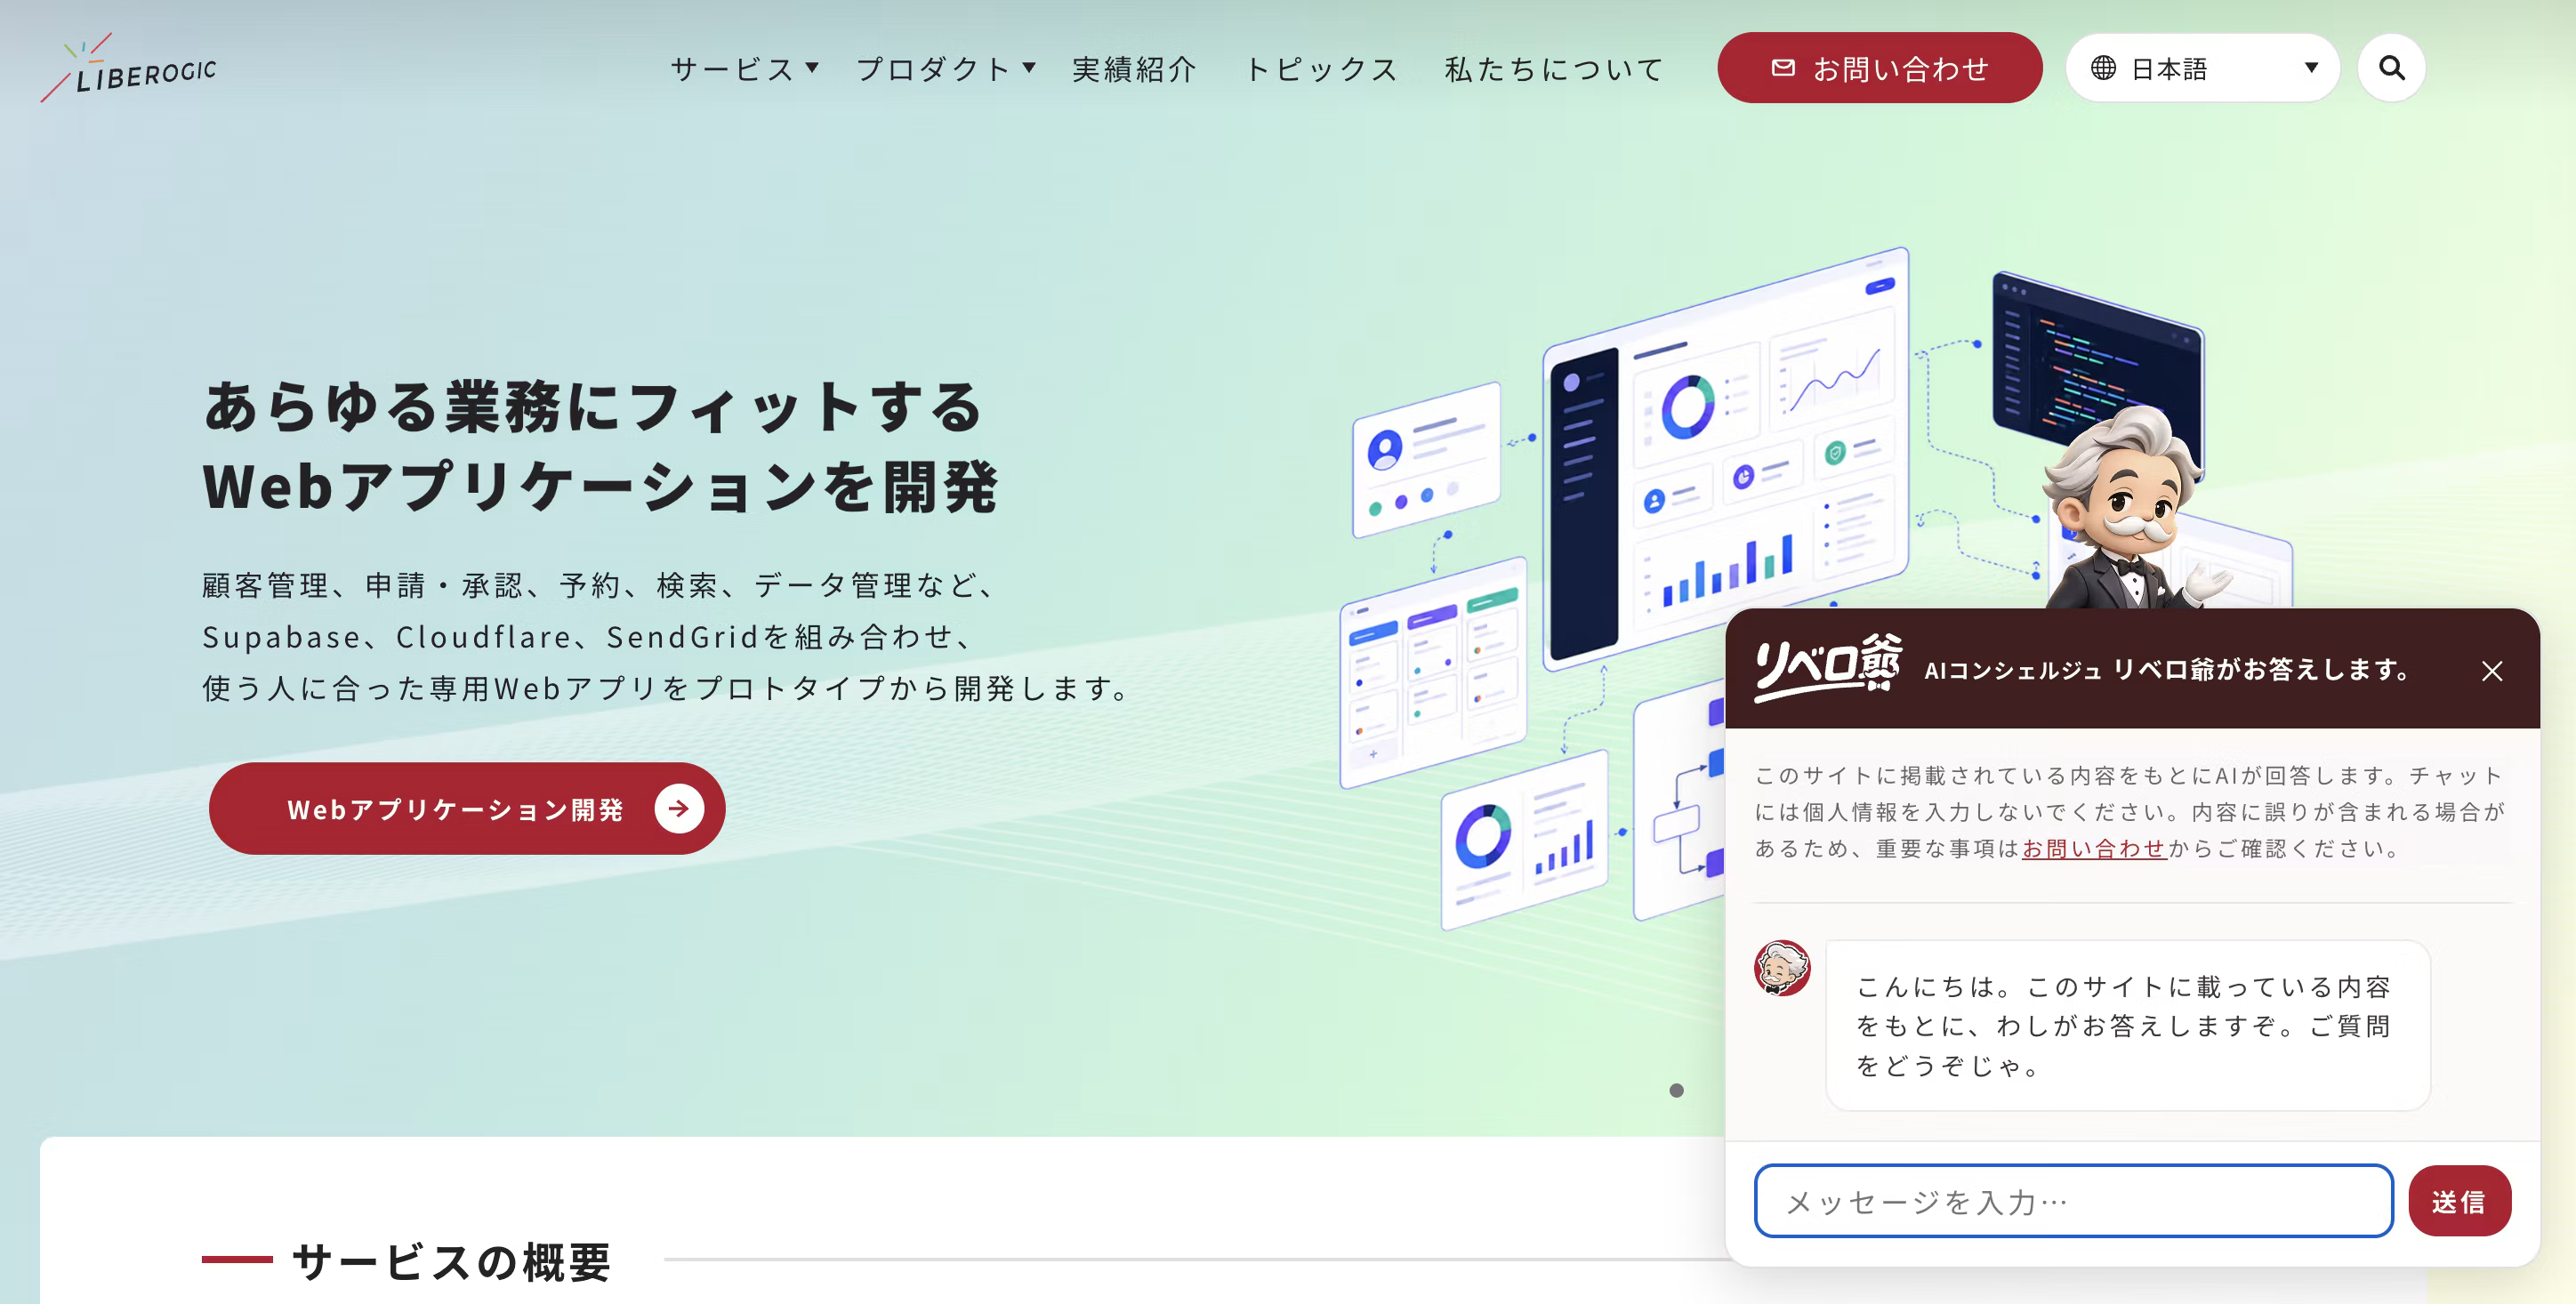
Usando el mismo AI Search, implementamos "AIコンシェルジュ リベロ爺", un chatbot que responde a partir del contenido del sitio.
En resumen, si ya tienes la búsqueda implementada, el coste adicional es bastante bajo.
El mecanismo de rastreo e indexación se puede reutilizar tal cual, y no hace falta preparar datos adicionales.
El trabajo principal no estuvo tanto en el código como en el ajuste de los prompts.
Utilizamos chat/completions
Como se explicó en la entrada anterior, la API de AI Search tiene dos variantes. search devuelve una lista de resultados de búsqueda, mientras que chat/completions genera una respuesta mediante RAG.
En la búsqueda dentro del sitio solo usamos la primera, pero esta vez usamos la segunda.
chat/completions realiza en una sola solicitud todo el proceso: generar la incrustación de la consulta, buscar los fragmentos relevantes en el índice y generar una respuesta con un LLM basada en esos fragmentos.
Como la búsqueda y el chat comparten el mismo índice, al actualizar una página los cambios se reflejan en ambos.
Arquitectura: una ruta de API y una interfaz de chat
La arquitectura sigue la misma idea que la anterior. Como no se pueden exponer los tokens de API en el navegador, usamos una ruta de API de Astro (Pages Functions) como proxy.
const res = await fetch(
  `https://api.cloudflare.com/client/v4/accounts/${id}/ai-search/instances/${name}/chat/completions`,
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}` },
    body: JSON.stringify({
      messages: [{ role: 'system', content: SYSTEM_PROMPT }, ...history],
      stream: false,
      ai_search_options: {
        retrieval: {
          retrieval_type: 'hybrid',
          max_num_results: 8, // 根拠として渡すチャンク数。増やすほど入力トークン=費用が増える
          filters: { locale: 'ja_JP' }, // チャットは日本語限定
        },
      },
    }),
  }
);
En el frontend, un único componente de interfaz de chat flotante en la esquina inferior derecha. El historial de conversación se guarda en un array separado del DOM de visualización, y al API solo se envían como máximo los últimos 10 mensajes, con un límite de 200 caracteres por mensaje.
Como el historial completo se cuenta como tokens de entrada en cada solicitud, limitarlo es clave para controlar los costes.
Gestión del prompt del sistema en el código
Aunque el prompt del sistema también puede configurarse desde el panel de control, decidimos pasarlo desde el código. Así, las revisiones y el historial de cambios quedan registrados en Git.
Así que el enfoque es más o menos este.
- Responder únicamente con base en la información de referencia proporcionada
- Si no hay base para responder (por ejemplo, detalles de precios o plazos de entrega), no especular y dirigir al usuario al formulario de contacto.
- Responder de forma concisa, en 3 a 4 oraciones. Cuando se pueda responder, no añadir advertencias como "el sitio no lo menciona".
Contra las alucinaciones: mostrar siempre las fuentes
La respuesta devuelve, junto con la contestación, los fragmentos utilizados como base. Los agrupamos por URL y los mostramos siempre debajo de la respuesta como "Páginas consultadas". Así el usuario puede acceder de inmediato a la información primaria y no se ve obligado a aceptar la respuesta de la IA sin verificarla.
En sitios multilingües, limitar el chat al japonés
En la entrada anterior expliqué cómo acotar la búsqueda al idioma de visualización mediante los filters de metadatos locale. El chat usa el mismo filtro y basa sus respuestas solo en las páginas en japonés.
Además, limitamos la propia interfaz a las páginas en japonés. Decidimos ofrecer el servicio solo en los idiomas en los que podemos garantizar la calidad de las respuestas.
Accesibilidad
Como la interfaz del chat muestra mensajes que se van añadiendo dinámicamente, la compatibilidad con tecnologías de asistencia se incorporó desde el principio.
- El área de registro usa
role="log"+aria-live="polite", de modo que solo se leen en voz alta los mensajes nuevos - La distinción entre quién habla no depende solo del aspecto visual (color y posición de los globos), sino que también se añaden etiquetas solo para lectores de pantalla, "Tú:" y "IA:"
- Con Esc se cierra y el foco vuelve al botón de alternancia; al abrirlo, el foco pasa al campo de entrada
El coste es visible por pregunta en AI Gateway
Las llamadas internas de AI Search pueden observarse en los registros de AI Gateway. Cada pregunta genera dos líneas: "incrustación de la consulta (bge-m3, alrededor de $0.0000001)" y "generación de la respuesta (modelo generativo)". Como el número de registros del modelo generativo equivale directamente al número de preguntas, también resulta sencillo seguir el uso.
Por cierto, en los registros aparecen muchas líneas de bge-m3 adicionales; corresponden a la actualización del índice durante el rastreo. Como su coste es un orden de magnitud mayor, se distinguen fácilmente.
No conviene tener expectativas excesivas: el conocimiento se limita al contenido del sitio; la inteligencia depende del modelo
Por ahora solo lee el contenido publicado en el sitio, así que el alcance de las respuestas es limitado. AI Search también puede usar un bucket de R2 como fuente de datos, por lo que es posible ampliarlo, por ejemplo, documentando propuestas anteriores para que formen parte del conocimiento disponible.
Además, "que solo hable del contenido del sitio" no significa "que no mienta". Puede malinterpretar fragmentos o mezclar varias páginas y, con ello, afirmar con aparente credibilidad algo que no está escrito. Mostrar siempre las fuentes es precisamente la salvaguarda frente a esto.
Además, el modelo que estamos generando es un modelo abierto y económico de Meta (de la familia Llama) que se ejecuta en Workers AI, y su capacidad es claramente inferior a la de los modelos comerciales más recientes. Si se busca más precisión, lo realista es cambiar de modelo a cambio de un aumento de costos.
Conclusión
Si ya tiene AI Search integrado para la búsqueda dentro del sitio, añadir un chatbot requiere solo "una ruta de API + una UI + un prompt". La mayor ventaja es que no hay doble gestión de datos: al actualizar la página, tanto la búsqueda como el chat mejoran de la misma manera.
Por otro lado, la calidad de las respuestas depende del modelo generativo y del prompt. Conviene asumir que la personalidad del asistente y las pautas de respuesta deben ajustarse con paciencia, revisando los registros reales. No basta con "instalarlo y dejarlo así". Aun así, para un RAG en un sitio corporativo, creo que es una opción bastante sencilla.




Pasó del DTP al mundo web y, sin darse cuenta, domina el maquetado, el frontend, la dirección de proyectos y la accesibilidad: un auténtico "maestro de todas las técnicas". Desde los inicios de Liberogic ha desempeñado múltiples funciones y hoy es una auténtica enciclopedia viviente dentro de la empresa. Últimamente se ha obsesionado con la optimización mediante prompts, preguntándose: «¿No podríamos apoyarnos más en la IA para la accesibilidad?». Su tecnología y su forma de pensar siguen evolucionando.
Ayumu Futamata
Especialista en Accesibilidad Web certificado por IAAP (WAS) / Ingeniero de marcado / Ingeniero frontend / Director web