

Dans mon précédent article, j'expliquais comment implémenter la recherche sur le site avec Cloudflare AI Search. Voici la suite.
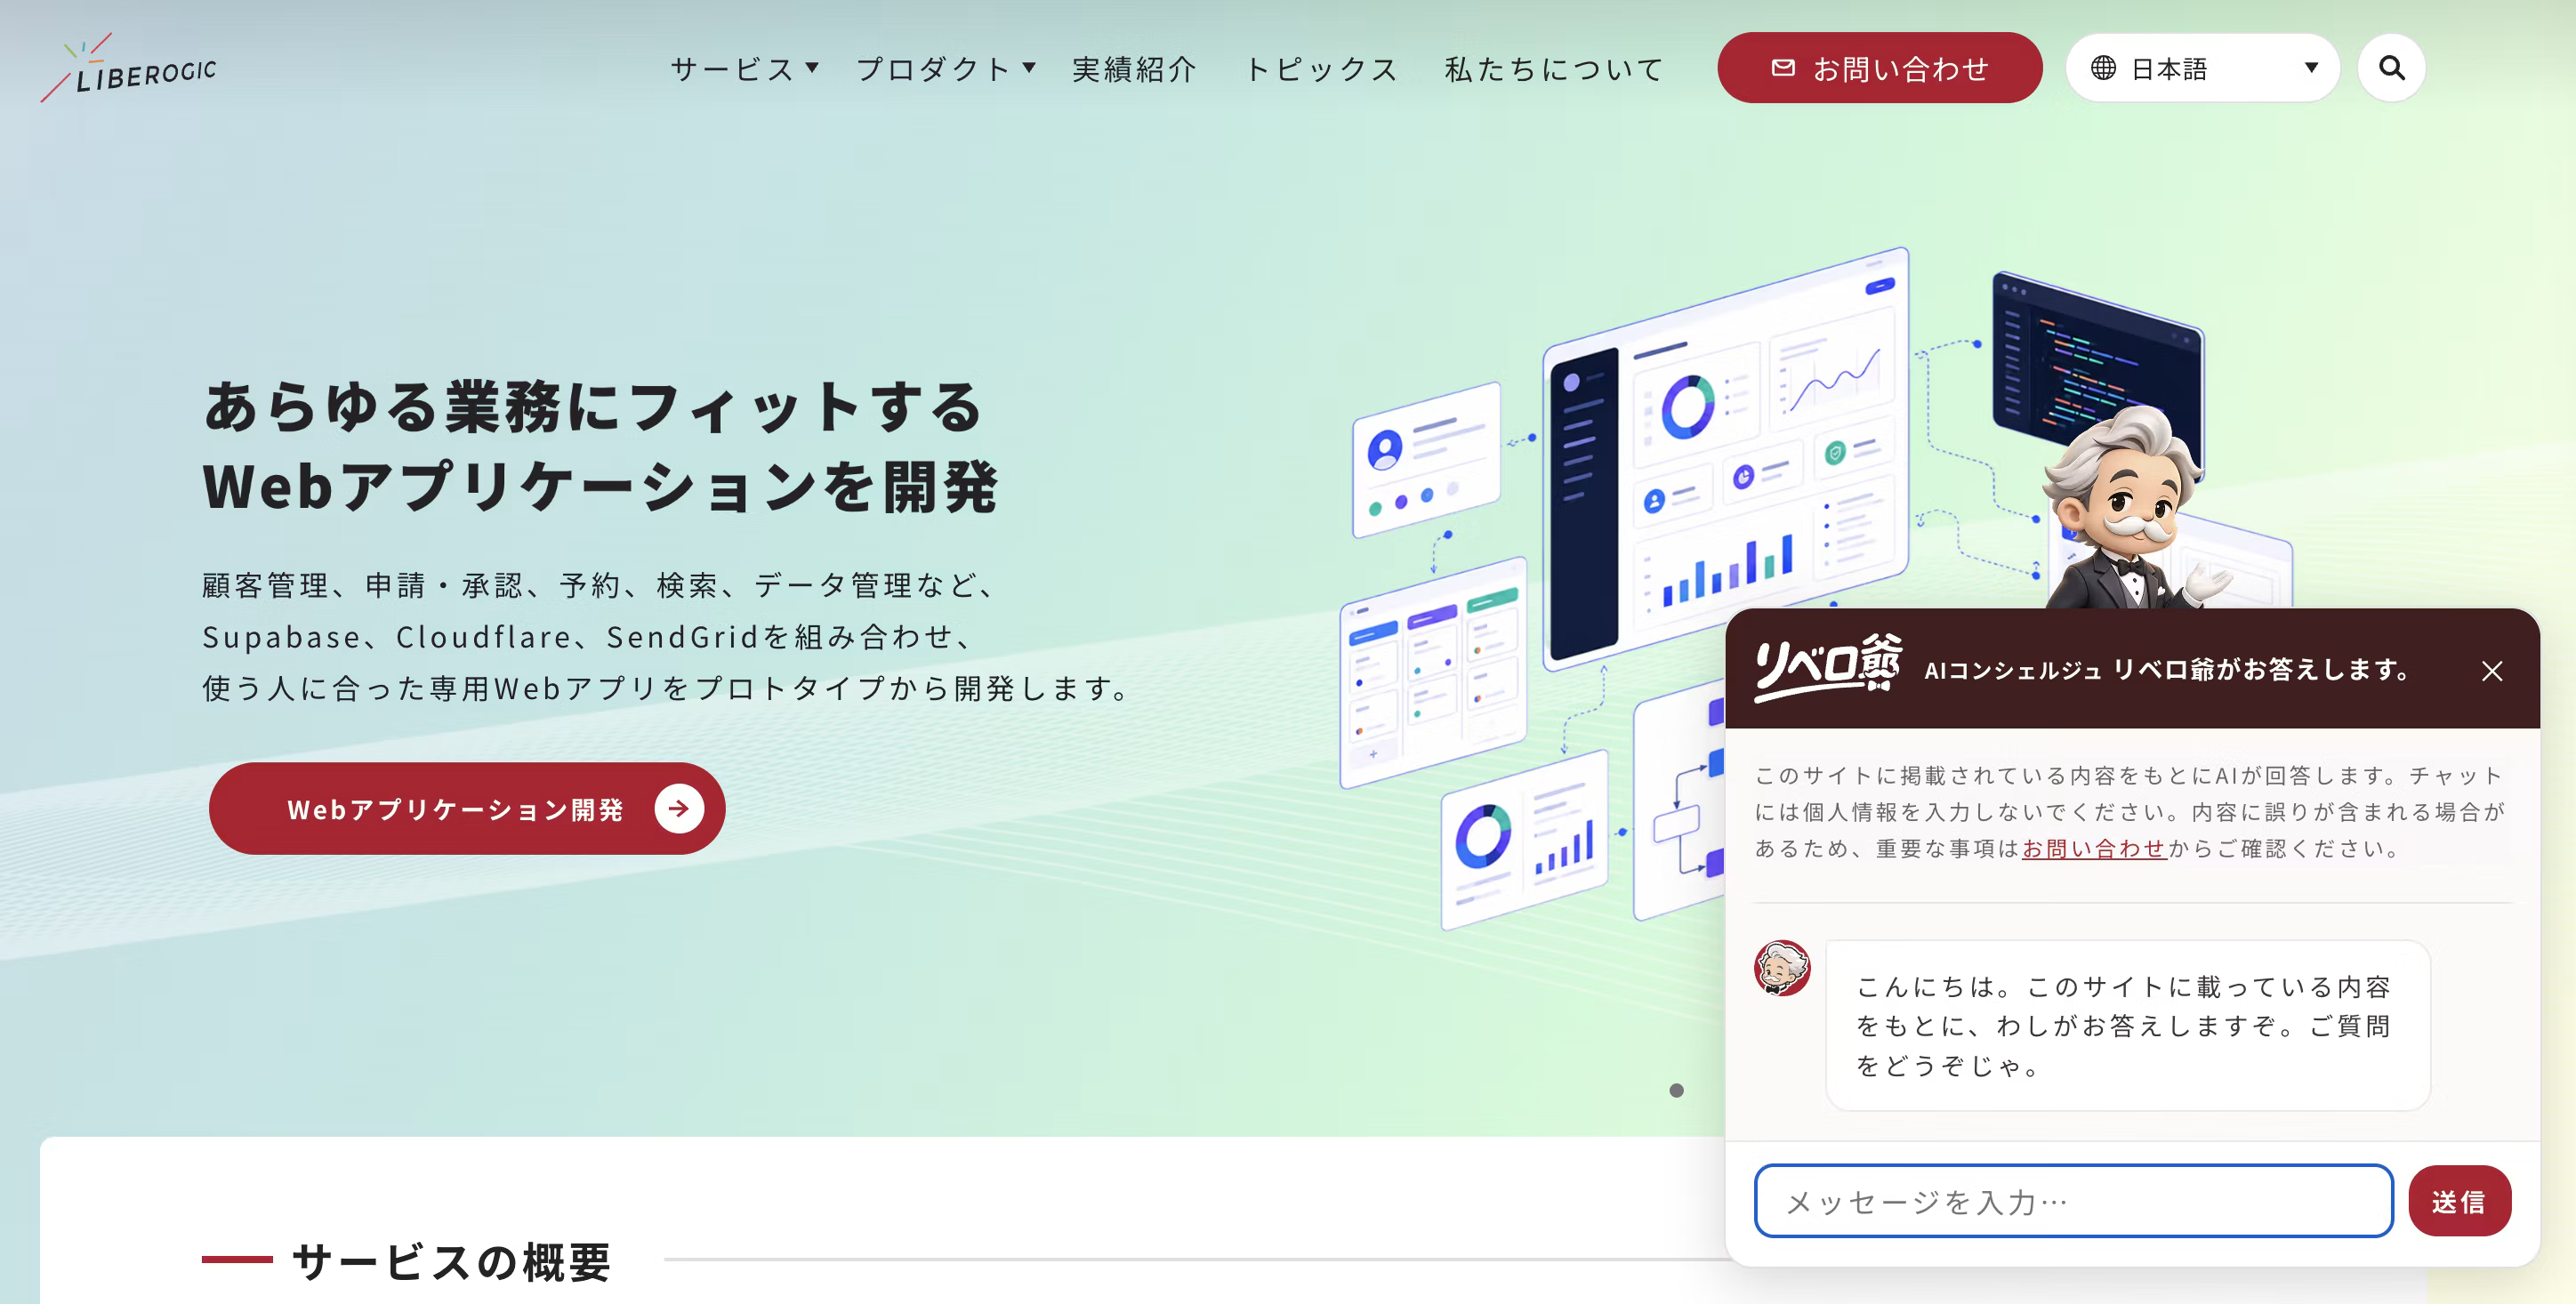
En utilisant le même AI Search, nous avons implémenté « AIコンシェルジュ リベロ爺 », un chatbot qui répond à partir du contenu du site.
En résumé, si la recherche est déjà en place, le coût supplémentaire est très faible.
Le mécanisme de crawl et d'indexation peut être réutilisé tel quel, et aucune préparation de données supplémentaire n'est nécessaire.
L'essentiel du travail a porté sur le réglage des prompts plutôt que sur le code.
Nous utilisons chat/completions
Comme indiqué dans mon précédent article, l'API d'AI Search comporte deux familles de fonctions.
D'un côté, search renvoie une liste de résultats de recherche, et de l'autre, chat/completions génère une réponse par RAG.
Pour la recherche sur le site, nous n'avions utilisé que la première, mais cette fois c'est la seconde.
chat/completions gère en une seule requête l'ensemble du processus : création de l'embedding de la requête, recherche des fragments pertinents dans l'index, puis génération d'une réponse par le LLM à partir de ces fragments.
Comme la recherche et le chat partagent le même index, une mise à jour de la page se répercute automatiquement sur les deux.
Architecture : une route API + une interface de chat
Là encore, le principe reste le même que précédemment : le jeton API ne pouvant pas être exposé dans le navigateur, les appels passent par une route API Astro (Pages Functions) qui sert de proxy.
const res = await fetch(
  `https://api.cloudflare.com/client/v4/accounts/${id}/ai-search/instances/${name}/chat/completions`,
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}` },
    body: JSON.stringify({
      messages: [{ role: 'system', content: SYSTEM_PROMPT }, ...history],
      stream: false,
      ai_search_options: {
        retrieval: {
          retrieval_type: 'hybrid',
          max_num_results: 8, // 根拠として渡すチャンク数。増やすほど入力トークン=費用が増える
          filters: { locale: 'ja_JP' }, // チャットは日本語限定
        },
      },
    }),
  }
);
Côté front, un seul composant d'interface de chat flottant en bas à droite. L'historique de conversation est conservé dans un tableau distinct du DOM d'affichage, et seuls les 10 derniers messages, limités à 200 caractères chacun, sont envoyés à l'API.
L'historique est intégralement comptabilisé comme jetons d'entrée à chaque requête. Limiter sa taille est donc la clé de la maîtrise des coûts.
Prompt système géré dans le code
Le prompt système peut aussi être défini depuis le tableau de bord, mais nous avons choisi de le transmettre depuis le code. Ainsi, les revues et l'historique des modifications restent dans Git.
Voici les grandes lignes.
- Répondre uniquement à partir des informations de référence fournies.
- Lorsqu'il n'existe pas de base suffisante pour répondre (détails tarifaires, délais de livraison, etc.), ne pas faire de suppositions et orienter l'utilisateur vers le formulaire de contact.
- Répondre de manière concise, en 3 à 4 phrases. Lorsqu'une réponse peut être apportée, ne pas ajouter de mention du type « ce n'est pas indiqué sur le site ».
Contre les hallucinations : afficher en permanence les sources.
La réponse renvoie, avec la réponse elle-même, les extraits (chunks) utilisés comme sources. Ces extraits sont regroupés par URL et affichés systématiquement sous la réponse, sous l'intitulé « Pages consultées ». Les utilisateurs peuvent ainsi accéder directement aux informations primaires, sans se fier aveuglément à la réponse de l'IA.
Sur les sites multilingues, limiter le chat au japonais
Dans un article précédent, nous expliquions comment restreindre la langue d'affichage de la recherche grâce aux filters sur les métadonnées locale. Le chat s'appuie lui aussi sur ce même filtre et ne se base que sur les pages en japonais.
Nous avons également limité l'interface elle-même aux pages en japonais. Le service n'est proposé que dans les langues permettant de garantir la qualité des réponses.
Accessibilité
Comme l'interface de chat affiche de nouveaux messages de manière dynamique, la prise en charge des technologies d'assistance a été intégrée dès le départ.
- La zone du journal utilise
role="log"etaria-live="polite", afin que seuls les nouveaux messages soient annoncés par les lecteurs d'écran - L'identification de l'auteur ne repose pas uniquement sur l'apparence (couleur et position des bulles) : des libellés réservés aux lecteurs d'écran, « Vous : » et « IA : », sont également ajoutés
- La touche Échap ferme la fenêtre et ramène le focus sur le bouton d'ouverture ; à l'ouverture, le focus est placé sur le champ de saisie
Les coûts sont visibles par question dans AI Gateway
Les appels internes d'AI Search sont observables dans les journaux d'AI Gateway. Une question correspond à deux lignes : « l'embedding de la requête (bge-m3, de l'ordre de 0,0000001 $) » et « la génération de la réponse (modèle de génération) ». Comme le nombre de journaux de génération correspond directement au nombre de questions, le suivi de l'utilisation est également simple.
À noter que les journaux contiennent aussi de nombreuses autres lignes bge-m3 : il s'agit des mises à jour d'index lors de l'exploration du site. Comme ce traitement par lots coûte un ordre de grandeur de plus, il est facile de les distinguer.
Pas d'attentes excessives : les connaissances se limitent au contenu du site, l'intelligence dépend du modèle
Pour l'instant, seul le contenu publié sur le site est lu, donc la portée des réponses reste limitée. AI Search peut aussi utiliser un bucket R2 comme source de données : il est donc possible d'étendre les connaissances en documentant, par exemple, d'anciennes propositions commerciales.
Par ailleurs, « ne parler que du contenu du site » ne signifie pas « ne jamais mentir ». Une mauvaise lecture d'un extrait ou une confusion entre plusieurs pages peut amener le système à affirmer avec assurance des choses qui ne figurent pas dans le site. L'affichage permanent des sources sert précisément de garde-fou.
Par ailleurs, le modèle que nous utilisons est un modèle ouvert et économique de Meta (de la famille Llama), exécuté sur Workers AI. Ses capacités sont nettement inférieures à celles des modèles commerciaux les plus récents. Si vous recherchez une plus grande précision, la solution réaliste consiste à changer de modèle, au prix d'une hausse des coûts.
Conclusion
Si AI Search est déjà intégré à la recherche interne de votre site, l'ajout d'un chatbot se limite à une route API, une interface utilisateur et un prompt. Le principal avantage est l'absence de double gestion des données : une mise à jour de la page améliore simultanément la recherche et le chat.
En revanche, la qualité des réponses dépend du modèle de génération et du prompt. Il faut partir du principe que la personnalité du chatbot et les règles de réponse devront être ajustées progressivement à partir des journaux réels. Ce n'est pas une solution qu'on installe et qu'on oublie. Cela dit, pour un RAG de site d'entreprise, c'est une option très accessible.




Passé du DTP au Web, il maîtrise aussi bien le balisage que le frontend, la direction de projet et l'accessibilité : un véritable « sage de la technique ». Actif chez Liberogic depuis ses débuts, il est aujourd'hui une référence interne incontournable. Ces derniers temps, il explore avec passion l'optimisation par l'IA : « Ne pourrait-on pas davantage s'appuyer sur l'IA pour l'accessibilité ? » Sa technique comme sa réflexion continuent d'évoluer.
Ayumu Futamata
Spécialiste certifié en accessibilité web IAAP (WAS) / Intégrateur balisage / Ingénieur frontend / Directeur web