

In mijn vorige artikel schreef ik over het implementeren van zoekfunctionaliteit op de site met Cloudflare AI Search. Dit artikel is het vervolg.
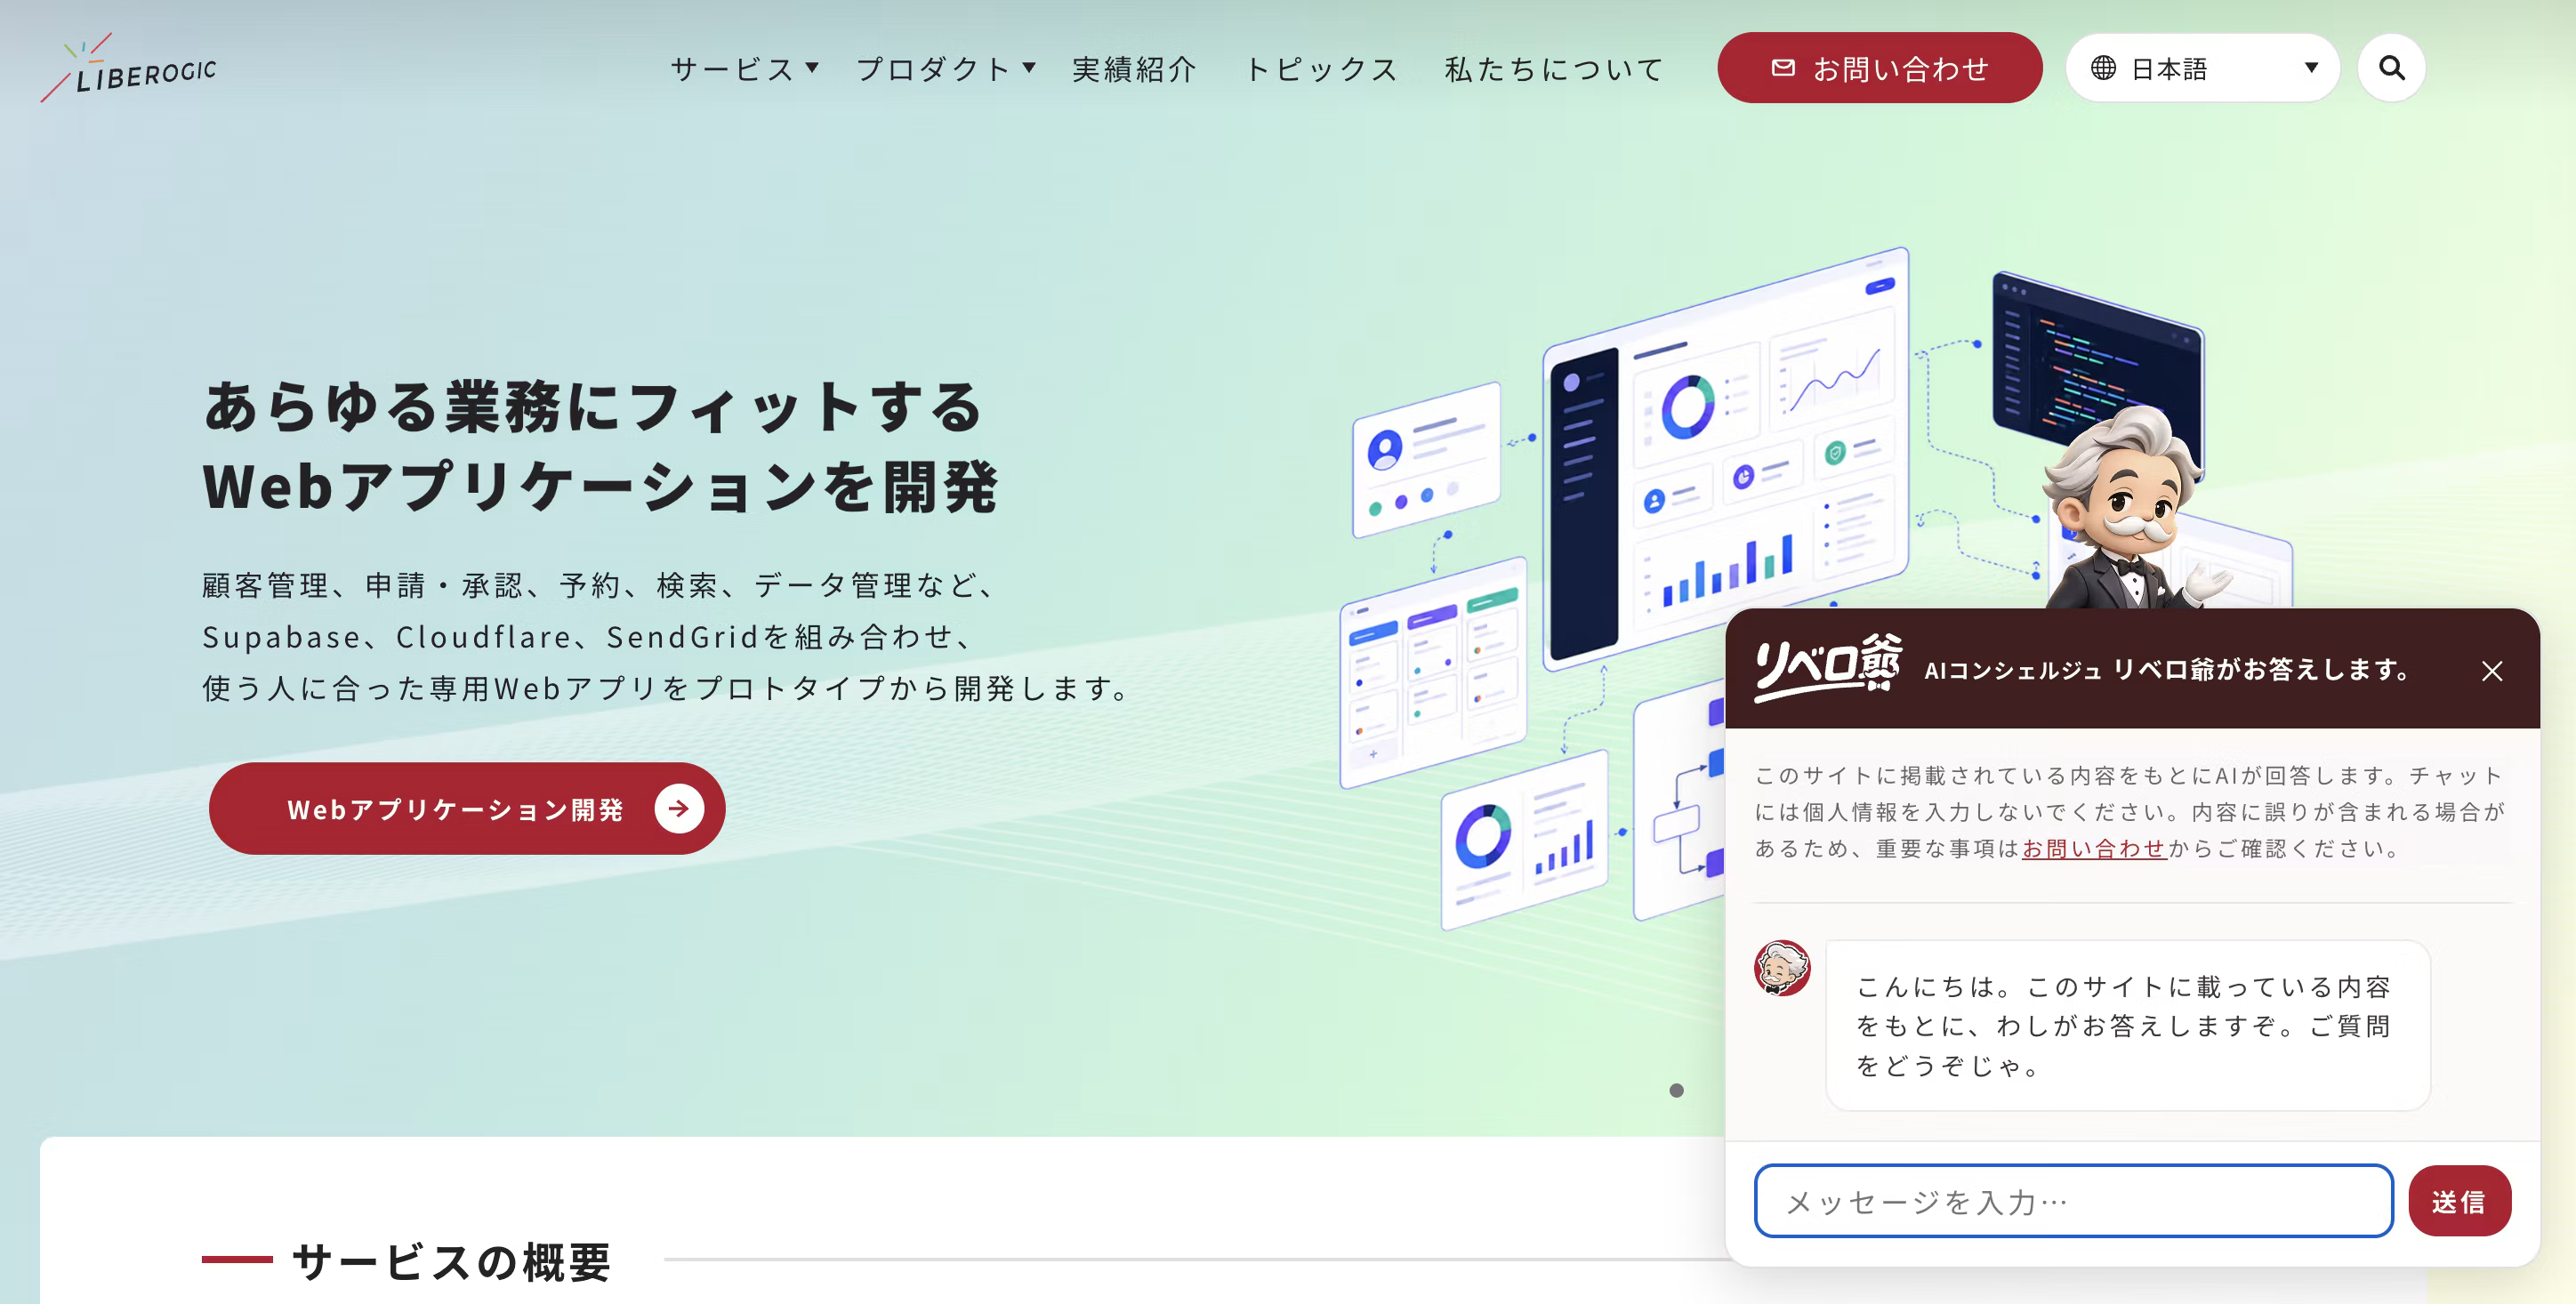
Met dezelfde AI Search heb ik een chatbot gebouwd die antwoorden geeft op basis van de inhoud van de site: de "AI-concierge Liberozee".
Kort gezegd: als je zoekfunctionaliteit al hebt geïmplementeerd, zijn de extra kosten vrij beperkt.
Het crawl- en indexeringsmechanisme kan ongewijzigd worden hergebruikt en er is geen extra datavoorbereiding nodig.
De grootste inspanning zat niet in de code, maar in het afstellen van de prompts.
Gebruikt: chat/completions
Zoals ik eerder beschreef, heeft de AI Search API twee varianten.
De ene, search, geeft een lijst met zoekresultaten terug. De andere, Voor de zoekfunctie op de site gebruikte ik de eerste, maar voor deze chatbot gebruik ik de tweede.
chat/completions, genereert een antwoord met RAG.
chat/completions voert in één verzoek alles uit: het maken van een embedding van de vraag, het zoeken naar relevante fragmenten in de index en het genereren van een antwoord door de LLM op basis van die fragmenten.
Zoeken en chatten gebruiken dezelfde index, dus wanneer een pagina wordt bijgewerkt, wordt dat in beide tegelijk zichtbaar.
Opbouw: één API-route en één chat-UI
Ook de opzet is vergelijkbaar met vorige keer: omdat een API-token niet in de browser mag worden blootgesteld, loopt het verkeer via een API-route van Astro (Pages Functions) als proxy.
const res = await fetch(
  `https://api.cloudflare.com/client/v4/accounts/${id}/ai-search/instances/${name}/chat/completions`,
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}` },
    body: JSON.stringify({
      messages: [{ role: 'system', content: SYSTEM_PROMPT }, ...history],
      stream: false,
      ai_search_options: {
        retrieval: {
          retrieval_type: 'hybrid',
          max_num_results: 8, // 根拠として渡すチャンク数。増やすほど入力トークン=費用が増える
          filters: { locale: 'ja_JP' }, // チャットは日本語限定
        },
      },
    }),
  }
);
De frontend bestaat uit één zwevende chat-UI-component rechtsonder. De gespreksgeschiedenis wordt apart van de weergave in een array bijgehouden. Naar de API wordt alleen de laatste 10 berichten gestuurd, met een maximum van 200 tekens per bericht.
De volledige geschiedenis wordt bij elk verzoek als invoertokens meegerekend, dus het beperken daarvan is de kern van het kostenbeheer.
Systeemprompt beheerd in de code
Antwoordrichtlijnen kunnen ook worden ingesteld via het "Systeemprompt"-paneel in het dashboard, maar ik heb gekozen om ze in de code mee te geven. Zo blijven review en wijzigingsgeschiedenis bewaard in Git.
Dit is ongeveer de aanpak.
- Antwoorden uitsluitend op basis van de verstrekte referentie-informatie
- Als er geen onderbouwing is en de vraag niet beantwoord kan worden (bijvoorbeeld details over tarieven of levertijden), wordt er niet gegist, maar wordt de gebruiker doorverwezen naar het contactformulier.
- Beknopt, in 3 tot 4 zinnen. Voeg bij een beantwoorde vraag geen disclaimer toe zoals "Dit staat niet op de website".
Tegen hallucinaties: bronvermelding wordt altijd zichtbaar getoond
Het antwoord bevat naast de tekst ook de fragmenten die als onderbouwing zijn gebruikt. Deze worden per URL samengevoegd en onder het antwoord altijd getoond als "Geraadpleegde pagina's". Zo kan de gebruiker direct de primaire bron raadplegen en wordt het AI-antwoord niet blindelings overgenomen.
Op meertalige sites is de chat beperkt tot Japans
Eerder schreef ik dat zoeken de weergavetaal beperkt door te filteren op locale-metadata via filters. De chat gebruikt hetzelfde filter, zodat alleen Japanstalige pagina's als onderbouwing dienen.
Daarnaast heb ik de UI zelf beperkt tot Japanstalige pagina's. We bieden de functie alleen aan in talen waarin we de antwoordkwaliteit kunnen waarborgen.
Toegankelijkheid
Omdat de chat-UI een interface is waarin berichten dynamisch worden toegevoegd, is ondersteuning voor hulptechnologieën vanaf het begin ingebouwd.
- Het loggebied gebruikt
role="log"enaria-live="polite", zodat alleen nieuwe berichten worden voorgelezen - Het onderscheid tussen sprekers wordt niet alleen visueel gemaakt (kleur en positie van de tekstballonnen), maar ook met alleen voor schermlezers bedoelde labels "Jij:" en "AI:"
- Met Esc sluit het venster en keert de focus terug naar de wisselknop; wanneer het venster opent, gaat de focus naar het invoerveld
De kosten zijn per vraag zichtbaar in AI Gateway
De aanroepen achter AI Search zijn zichtbaar in de logs van AI Gateway. Eén vraag = twee regels: "query-embedding (bge-m3, ongeveer $0.0000001)" en "generatie van het antwoord (generatiemodel)". Omdat het aantal logregels van het generatiemodel gelijk is aan het aantal vragen, is het gebruik eenvoudig te overzien.
Overigens verschijnen er in de logs ook veel regels van bge-m3. Die komen van het bijwerken van de index tijdens het crawlen. Omdat de kosten daarvan een factor tien hoger liggen, zijn ze snel te herkennen.
Verwacht niet te veel: de kennis komt alleen uit de inhoud van de site, de intelligentie hangt af van het model
Op dit moment leest de chatbot alleen de inhoud die op de site is gepubliceerd, dus het aantal vragen dat hij kan beantwoorden is beperkt. AI Search kan ook R2-buckets als gegevensbron gebruiken. Zo kunnen bijvoorbeeld eerdere voorstellen als documentatie worden toegevoegd als kennisbron.
Daarnaast betekent "alleen de inhoud van de site" niet dat hij nooit onwaarheden vertelt. Het is mogelijk dat hij fragmenten verkeerd interpreteert of pagina's door elkaar haalt, en zo plausibel klinkende dingen zegt die nergens zijn opgeschreven. Daarom worden de bronnen altijd getoond als vangnet.
Daarnaast gebruiken we een goedkoop open model van Meta (Llama-familie) dat op Workers AI draait. Qua intelligentie blijft het duidelijk achter op de nieuwste commerciële modellen. Wilt u meer nauwkeurigheid, dan is de realistische aanpak om het model te vervangen, al brengt dat extra kosten met zich mee.
Conclusie
Als u al AI Search voor de zoekfunctie op uw site gebruikt, is een chatbot eenvoudig toe te voegen: één API-route, één UI-component en een prompt. Het grootste voordeel is dat u de data niet dubbel hoeft te beheren. Wanneer u de pagina's bijwerkt, worden zowel de zoekfunctie als de chatbot automatisch beter.
Aan de andere kant hangt de kwaliteit van de antwoorden af van het generatiemodel en de prompt. Reken erop dat u de persona en de antwoordrichtlijnen stap voor stap moet bijstellen op basis van echte gesprekslogs. Het is zeker niet een kwestie van inschakelen en klaar. Toch is dit, voor een RAG-chat op de schaal van een eigen website, een zeer praktische keuze.




Van DTP naar het web: al snel werkte hij aan markup, frontend, projectregie en accessibility, en beheerst hij alles. Actief bij Liberogic sinds de beginjaren en nu een levende encyclopedie binnen het bedrijf. Recentelijk verdiept hij zich, met prompts als hulpmiddel, in de vraag: "Kunnen we voor accessibility niet meer op AI leunen?" Technologie en denkwijze blijven zich ontwikkelen.
Ayumu Futamata
IAAP-gecertificeerd webaccessibility-specialist (WAS) / Markup-engineer / Frontend-engineer / Webdirecteur