

Op 27 november 2025 hebben we deelgenomen aan de "Data & AI Summit '25 Fall", georganiseerd door Google.
Onlangs hebben we besloten om ook bij ons op kantoor serieus werk te maken van "datagebruik". Er is in stilte een project gestart. In het begin pakten we het heel relaxed aan, "stap voor stap, waar het kan". Toen hoorden we op een dag dat Google de "Data & AI Summit '25 Fall" organiseerde.
"We moeten zeker op de hoogte blijven van de nieuwste trends in datagebruik!" Met die gedachte zijn we er vrijblijvend heen gegaan, en dat bleek een goede keuze. We hoorden veel interessante verhalen, meer dan we hadden verwacht.
Wat is de Data & AI Summit '25 Fall?
Uit de naam van het evenement kun je al ongeveer opmaken dat het hoofdthema "AI-agents" was. Het evenement vond hybride plaats en trok ongeveer 3.000 deelnemers, een groot succes. Ik was er persoonlijk bij, en bij sommige sessies stonden de mensen in de rij of moesten ze staan omdat de stoelen op waren. Je voelde gewoon hoe groot de belangstelling is voor datagebruik en AI.
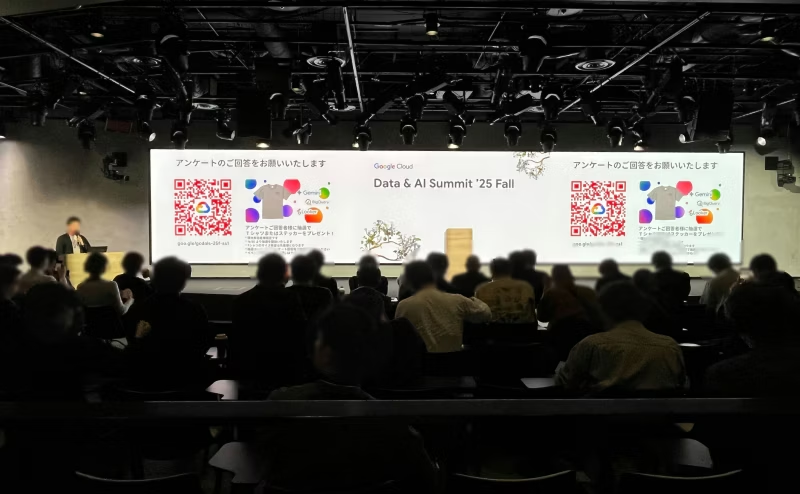
Het tijdschema voor de dag ziet er ongeveer zo uit.
https://cloudonair.withgoogle.com/events/data-ai-summit-25f
In dit artikel doen we verslag van de keynote en de sessies die ons het meest zijn bijgebleven!
Keynote: Naar een tijdperk van samenwerking met data-agents - De volgende generatie data-analyse op basis van een AI-Ready datafundament
De keynote bestond uit drie onderdelen: allereerst de presentatie van Hamada van Google Cloud over "drie vereisten voor AI-agents", vervolgens praktijkvoorbeelden van data-gebruik bij Lion Corporation en Mercari, en tot slot de demo van "conversationele analyse" door de technologieafdeling van Google.
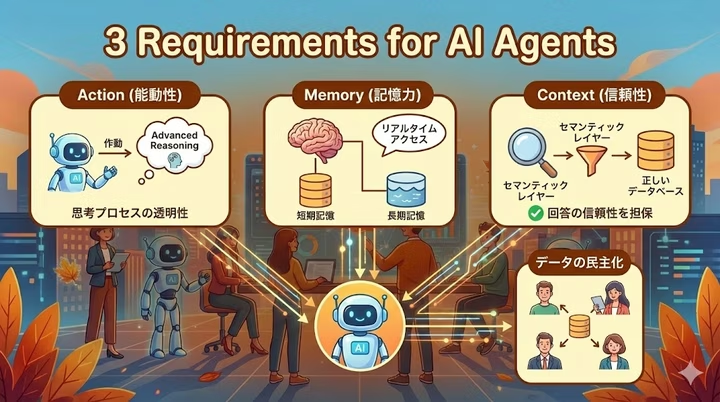
◼︎Drie vereisten voor AI-agents
Hamada presenteerde drie essentiële vereisten voor het daadwerkelijk inzetten van AI-agents in het bedrijfsproces: "Action" (proactiviteit), "Memory" (geheugen) en "Context" (betrouwbaarheid).
Action: AI-agents moeten proactief handelen in plaats van passief te blijven.
Een sleutelpunt hierbij is de "transparantie van het denkproces". Volgens de toelichting kan het concept van "Advanced Reasoning", waarbij een reeks stappen in fasen wordt uitgevoerd, de transparantie van analyses vergroten.
Memory: het "kortetermijngeheugen" en "langetermijngeheugen" die AI-agents nodig hebben om effectief te functioneren.
Bij de toelichting op het "langetermijngeheugen", waarbij AI-agents realtime toegang hebben tot de data van een bedrijf, werd een voorbeeld getoond van spraakinvoer om met een AI-agent te communiceren en een product te bestellen. Dat ging veel sneller dan het traditionele tikken op een scherm, en het gaf ons opnieuw het besef dat deze technologie al heel dicht bij ons dagelijks leven staat.
Context: context is absolutely essential to ensure the reliability of answers.
The session explained the importance of a "semantic layer" for guiding users to the correct database and calculation formulas.
I felt that the semantic layer came up often in the subsequent sessions as well, and that its level of attention is growing even further.
◼︎Case studies on data utilization
Lion Corporation presented on building a data foundation, and Mercari, Inc. introduced its efforts toward data democratization.
The topic of data democratization in particular left a strong impression, as it feels close to home. The approach of introducing AI agents to create an environment where anyone can access data, a domain previously reserved for analysts, is something our company would like to learn from.
At an internal sharing session held afterward, we also discussed wanting to adopt these ideas right away.
◼︎Demo of conversational analytics
Using "Conversation analytics agent in BigQuery" as an example, a demo of a conversational analytics agent was presented.
I had some experience with BigQuery, but I didn't know it could perform data analysis using natural language, so it was a real eye-opener. I was truly impressed by the comprehensive support, including improved data accuracy through Gemini suggestions and automatic generation of golden queries, as well as how relatively simple the setup is.
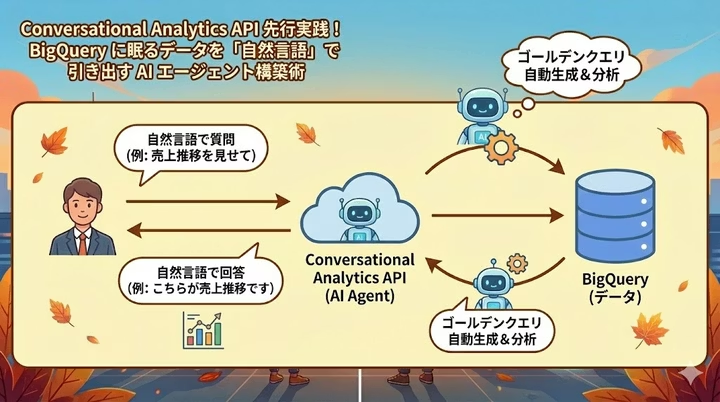
Conversational Analytics API als voorbeeld in de praktijk! Een handleiding voor het bouwen van AI-agents die data in BigQuery met natuurlijke taal ontsluiten
In een presentatie van Eyelet Co., Ltd. werd een praktijkvoorbeeld getoond waarin BigQuery en de Conversational Analytics API worden gecombineerd om data te analyseren via een chatinterface.
De inhoud draaide om het opslaan van websitedata in BigQuery, waarna de Conversational Analytics API het uitvoeren van queries en analysewerkzaamheden volledig overneemt. Door AI-agents toegankelijk te maken via communicatietools die dagelijks worden gebruikt, werd een omgeving gecreëerd waarin iedereen eenvoudig met data kan werken.
Het sloot naadloos aan bij de 'democratisering van data' die tijdens de keynote centraal stond, en de opzet is bovendien zeer eenvoudig. Wij willen dit graag snel in onze eigen werkzaamheden toepassen.
Zelf aan de slag gaan zou ik heel graag willen, maar gezien de praktische vaardigheden die daarvoor nodig zijn, zou dat jaren kosten. Daarom laten we dit graag over aan onze ingenieurs!
Minimale stappen! Een AI-agent met Google Trends-integratie in combinatie met productmasterdata
In een lezing van AEON Smart Technology Co., Ltd. werd toegelicht hoe AI wordt ingezet op 'productmasterdata', een aanpak die typisch is voor bedrijven met fysieke winkels.
Het thema betrof twee uitdagingen: het oplossen van vage zoekopdrachten en het automatisch koppelen aan trends. Beide onderdelen maakten gebruik van een opzet op basis van Google Vertex AI Search.
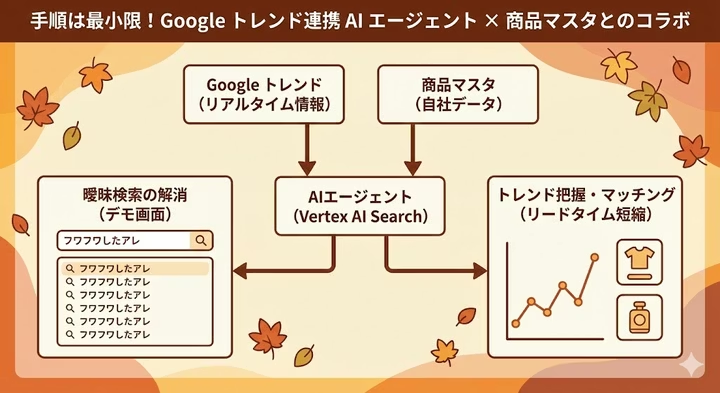
— Vage zoekopdrachten in productmasterdata met AI
Als typisch probleem voor bedrijven met fysieke winkels werd een voorbeeld gegeven van vage vragen van klanten zonder concrete productnaam. Traditionele systemen vereisen een exacte overeenkomst, waardoor vragen die mensen makkelijk kunnen beantwoorden voor het systeem een grote hindernis vormen. De presentatie beschreef een poging om dit met AI aan te pakken.
In de demo werd een systeem getoond dat ook bij vage zoekopdrachten, vergelijkbaar met een internetzoekopdracht, binnen een mum van tijd de juiste productinformatie uit big data haalt. Ik begreep de techniek niet helemaal, maar ik was er echt van onder de indruk dat een bedrijf dit allemaal al kan.
— Trends signaleren en automatisch koppelen aan productdata
Het doel is de doorlooptijd te verkorten, van het moment dat klantbehoeften ontstaan tot het moment dat producten daadwerkelijk in de winkel liggen. Daarvoor wordt een tool onderzocht die externe trendinformatie direct oppikt en deze automatisch koppelt aan de eigen productdata.
Ook dit was een interessant verhaal over geavanceerde technologie, en ik vond het erg boeiend. Ik kan nog niet goed voorstellen hoe we dit binnen onze dienstverlening kunnen inzetten, maar ik zou "Google Vertex AI Search" persoonlijk ook graag eens zelf uitproberen.
Conclusie
Ik heb alleen de sessies uitgelicht die mij het meest zijn bijgebleven. Hoe vonden jullie het? Ik hoop dat ik een deel van het enthousiasme over "de innovatie van data-agents" die ik op de dag zelf voelde, met jullie heb kunnen delen.
Eerlijk gezegd waren we met data-gebruik tot nu toe wat aan het aanmodderen, maar deelname aan deze summit was een erg goede aanleiding om te beseffen: "We moeten echt aan de slag, anders blijven we achter!"
Ik ga beginnen met het onderwerp dat tijdens de summit meermaals als cruciaal werd benadrukt: het definiëren van data en de semantische laag.



Als medewerker die direct na school bij ons in dienst kwam, werk ik momenteel hard aan mijn groei tot regisseur. Ik streef ernaar een veelzijdig professional te worden die alle disciplines beheerst, van design tot advertentiebeheer, en daag mezelf dagelijks uit. In mijn werk streef ik naar een slimme aanpak van projectregie, terwijl ik in mijn privéleven graag thuis ben en van mijn gezellige 'vesting' geniet. Ik houd ook van anime.
Handan-chan
Webdirecteur / in dienst sinds 2022