

Le 27 novembre 2025, nous avons assisté au « Data & AI Summit '25 Fall », organisé par Google.
Notre entreprise a récemment décidé de se lancer sérieusement dans l'exploitation des données. Un projet a donc été discrètement lancé. Au départ, nous avancions de manière assez détendue, en nous concentrant sur ce qui était faisable. Puis, un jour, nous avons appris que Google organisait le « Data & AI Summit '25 Fall ».
« Il faut absolument se tenir au courant des dernières tendances en matière d'exploitation des données ! » Nous y sommes allés l'esprit léger, et ce fut une excellente décision. Nous avons entendu bien plus d'interventions intéressantes que prévu.
Qu'est-ce que le Data & AI Summit '25 Fall ?
Le titre de l'événement laisse deviner le thème principal de la conférence : les « agents IA ». Organisé en format hybride, l'événement a attiré environ 3 000 participants, un vrai succès. J'y ai assisté en présentiel, et certaines conférences étaient si populaires qu'il y avait des files d'attente, et que des participants devaient suivre debout faute de places. On ressentait concrètement l'intérêt croissant pour l'exploitation des données et l'IA.
Voici le programme de la journée.
https://cloudonair.withgoogle.com/events/data-ai-summit-25f
Dans cet article, nous revenons sur la conférence d'ouverture et les sessions qui nous ont le plus marqués !
Conférence d'ouverture : à l'ère de la collaboration avec les agents de données - Analyse de données nouvelle génération grâce à une base de données AI-Ready
La conférence d'ouverture s'est articulée en trois temps : d'abord, « Les trois exigences des agents d'IA » présenté par M. Hamada de Google Cloud, puis des exemples concrets d'utilisation des données chez Lion Corporation et Mercari, Inc., et enfin la présentation publique, par le département technologique de Google, d'une démonstration d'analyse conversationnelle.
◼︎ Les trois exigences des agents d'IA
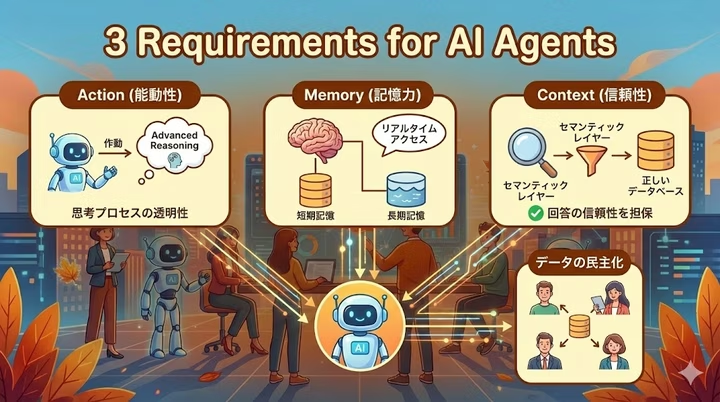
M. Hamada a présenté les trois exigences indispensables pour déployer pleinement des agents d'IA et leur confier des tâches métier : « Action » (proactivité), « Memory » (mémoire) et « Context » (fiabilité).
Action : un agent d'IA ne doit pas être passif, mais initier activement des actions.
Un point clé est ici la « transparence du processus de réflexion ». Selon l'intervenant, améliorer la transparence de l'analyse passe par le concept d'« Advanced Reasoning », qui consiste à décomposer un enchaînement de flux en étapes distinctes.
Memory : la « mémoire à court terme » et la « mémoire à long terme », essentielles au bon fonctionnement d'un agent d'IA.
Lors de la présentation sur la « mémoire à long terme », qui permet d'accéder en temps réel aux données détenues par une entreprise, un cas d'usage a été montré : passer une commande produit en communiquant à voix haute avec un agent d'IA. Cette méthode est bien plus rapide que la saisie par tapotement, et l'on mesure à quel point ces technologies deviennent déjà familières.
Context : le contexte est indispensable pour garantir la fiabilité des réponses.
La présentation a expliqué l'importance de la « couche sémantique », qui permet d'accéder à la base de données ou à la formule de calcul correctes.
J'ai eu le sentiment que la couche sémantique revenait souvent dans les conférences suivantes, et qu'elle gagnait encore en attention.
◼︎ Présentation de cas d'utilisation des données
Lion Corporation a présenté la construction de son infrastructure de données, et Mercari, Inc. a partagé ses initiatives en faveur de la démocratisation des données.
La démocratisation des données m'a particulièrement marqué, car ce sujet nous touche de près. Grâce à l'introduction d'agents IA, un environnement permettant à chacun d'accéder aux données, un domaine jusqu'alors réservé aux analystes, est en train de voir le jour. Nous aimerions nous inspirer de cette approche.
Lors d'un échange interne organisé par la suite, nous avons aussi discuté de la rapidité avec laquelle nous pourrions mettre ces idées en pratique.
◼︎ Démonstration publique d'analyse conversationnelle
Une démonstration d'agent d'analyse conversationnelle a été présentée, à partir de « Conversation analytics agent in BigQuery ».
Bien que j'utilise déjà BigQuery, je ne savais pas qu'il permettait désormais d'effectuer des analyses de données en langage naturel. C'est une véritable révélation. Les fonctionnalités d'assistance sont également riches, notamment l'amélioration de la précision des données grâce aux suggestions de Gemini et la génération automatique de requêtes de référence (golden queries). J'ai été impressionné de constater que la configuration restait relativement simple.
Pratique de l'API Conversational Analytics : construire un agent IA qui exploite en langage naturel les données dormant dans BigQuery !
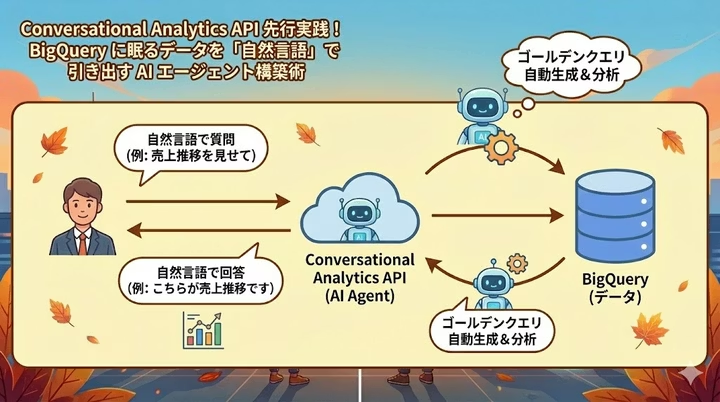
Lors de la présentation d'Eiret Inc., un cas d'analyse de données en mode conversationnel combinant BigQuery et l'API Conversational Analytics a été présenté.
Le principe consistait à accumuler les données du site dans BigQuery, puis à confier entièrement l'exécution des requêtes et les tâches d'analyse à l'API Conversational Analytics. En rendant l'agent IA accessible depuis l'outil de communication utilisé au quotidien, l'environnement mis en place permet à chacun d'exploiter les données facilement.
Cette approche incarne précisément la « démocratisation des données » évoquée lors de la conférence d'ouverture, et sa structure est très simple. Nous avons immédiatement eu envie de l'intégrer à notre propre pratique.
Nous aimerions beaucoup le mettre en œuvre nous-mêmes, mais compte tenu de nos compétences actuelles, cela nous prendrait sans doute plusieurs années. Nous allons donc confier ce travail à nos ingénieurs !
Un minimum d'étapes : agent IA connecté à Google Trends et collaboration avec la base de données produits
Lors de la présentation d'AEON Smart Technology Co., Ltd., l'entreprise a expliqué comment elle utilise l'IA sur les données de référentiel produits, une démarche propre aux entreprises disposant de points de vente physiques.
Le sujet portait sur deux défis : la levée de l'ambiguïté de la recherche et la mise en correspondance automatique avec les tendances. Les deux solutions reposaient sur une architecture utilisant Google Vertex AI Search.
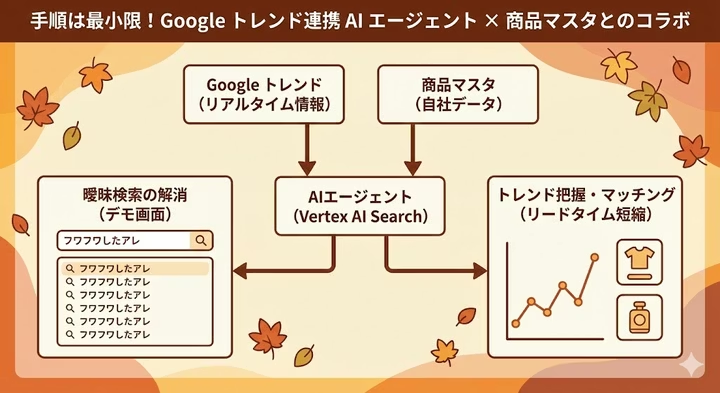
— Recherche floue sur le référentiel produits grâce à l'IA
Comme problème propre aux entreprises disposant de points de vente physiques, l'intervenant a pris l'exemple de questions vagues de clients ne mentionnant aucun nom de produit précis. Les systèmes traditionnels exigent une correspondance exacte, si bien qu'une question à laquelle un humain répond facilement devient un obstacle majeur pour le système. L'approche présentée consistait à utiliser l'IA pour résoudre ce problème.
La démo présentait un système capable de fournir instantanément des informations produit pertinentes à partir de Big Data, même pour des requêtes vagues comparables à une recherche sur Internet. Je n'ai pas vraiment saisi le fonctionnement, mais j'ai simplement été impressionné qu'une entreprise puisse aller aussi loin.
— Suivi des tendances et mise en correspondance automatique avec les données produit
Il s'agissait de présenter un outil à l'étude, qui capte instantanément des informations de tendance externes et les associe automatiquement aux données produit de l'entreprise, afin de réduire le délai entre l'émergence d'un besoin client et la mise en rayon effective des produits.
Il s'agissait également d'une technologie de pointe, et c'était vraiment passionnant. Je ne vois pas encore clairement comment elle pourrait servir nos services, mais j'ai personnellement envie d'essayer « Google Vertex AI Search ».
Conclusion
Je n'ai présenté que les sessions qui m'ont le plus marqué, j'espère que cela vous a plu ? Si j'ai pu partager, ne serait-ce qu'en partie, l'enthousiasme que j'ai ressenti lors de « L'innovation apportée par les agents de données », je serais très heureux.
Franchement, nous avions parfois traîné les pieds sur l'exploitation des données, mais la participation à ce sommet a été une très bonne occasion de me dire : « Il faut vraiment se lancer sérieusement, pour ne pas être laissé de côté par cette vague ! »
Pour commencer, je compte partir de la définition des « données et de la couche sémantique », dont l'importance a été soulignée à plusieurs reprises au cours de cette session.



Directeur en pleine ascension depuis son entrée dans l'entreprise en tant que jeune diplômé, actuellement très investi ! Il relève chaque jour le défi de devenir un profil polyvalent, maîtrisant tous les domaines, du design à la gestion publicitaire. Au travail, il vise une direction élégante et efficace, tandis que dans sa vie privée, il savoure pleinement une existence casanière dans sa forteresse qu'il appelle sa maison. Il aime aussi les animes.
Handan-chan
Directeur web / Entré en 2022