

El 27 de noviembre de 2025 asistimos a "Data & AI Summit '25 Fall", organizado por Google.
Recientemente, nuestra empresa decidió apostar en serio por el "aprovechamiento de datos", y así comenzó discretamente un proyecto. Al principio lo abordábamos de forma muy relajada, "poco a poco y con lo que podamos", pero un día nos enteramos de que se celebraría el "Data & AI Summit '25 Fall" organizado por Google.
Pensamos: "¡Tenemos que estar al día de las últimas tendencias en aprovechamiento de datos!". Así que decidimos asistir con una actitud despreocupada, y resultó ser una gran decisión. Escuchamos muchas charlas valiosas, mucho más de lo que esperábamos.
¿Qué es Data & AI Summit '25 Fall?
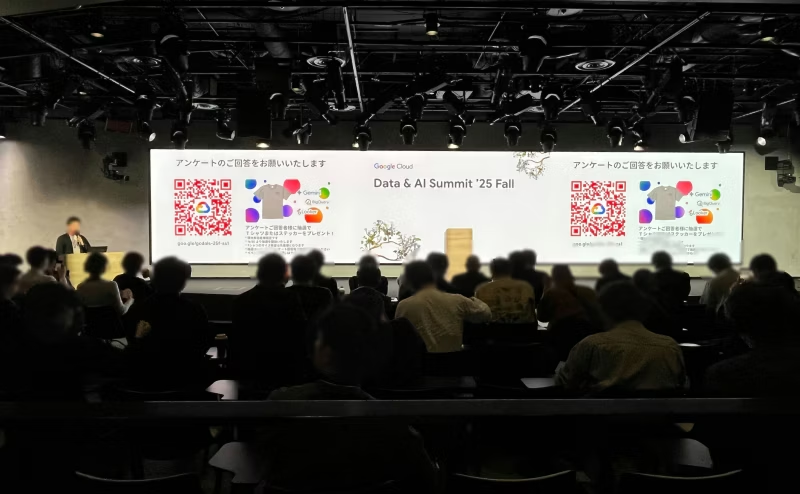
Por el nombre del evento, probablemente pueda imaginarlo: el tema central de las charlas fue los "agentes de IA". Fue un evento híbrido con alrededor de 3,000 asistentes, con una gran afluencia. Yo asistí presencialmente, y en algunas charlas había filas de espera o no había suficientes asientos, por lo que la gente tenía que seguir de pie. Pudimos percibir de primera mano el enorme interés por el aprovechamiento de datos y la IA.
Este es el horario del día.
https://cloudonair.withgoogle.com/events/data-ai-summit-25f
En este artículo informamos sobre la keynote y las sesiones que más nos impresionaron.
Keynote: La era de la co-creación con agentes de datos: análisis de datos de nueva generación con una base de datos AI-Ready
La keynote comenzó con "Tres requisitos para los agentes de IA" a cargo de Hamada de Google Cloud, y continuó con casos prácticos de uso de datos en LION Corporation y Mercari, Inc., y, por último, con la demostración pública de "análisis conversacional" del departamento de tecnología de Google.
◼︎Tres requisitos para los agentes de IA
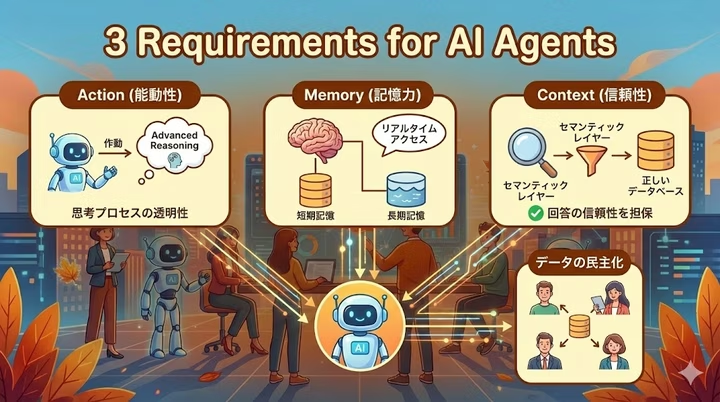
Hamada presentó tres requisitos indispensables para implantar agentes de IA de forma efectiva y encargarles tareas de negocio: "Action" (proactividad), "Memory" (capacidad de memoria) y "Context" (fiabilidad).
Action: los agentes de IA no deben ser pasivos, sino emprender acciones de forma proactiva.
Aquí cobra importancia la "transparencia del proceso de razonamiento". Según la explicación, el concepto de "Advanced Reasoning", que divide un flujo completo en etapas, es clave para mejorar la transparencia del análisis.
Memory: la "memoria a corto plazo" y la "memoria a largo plazo" para que los agentes de IA funcionen con eficacia.
En la explicación sobre la "memoria a largo plazo", que permite acceder en tiempo real a los datos que posee una empresa, se presentó un caso en el que se realizaban pedidos de productos mediante comandos de voz con un agente de IA. Esto volvió a confirmarnos que, en comparación con las operaciones tradicionales por toque, es mucho más rápido y que esta tecnología ya está empezando a formar parte de nuestra vida cotidiana.
Contexto: el contexto es imprescindible para garantizar la fiabilidad de las respuestas.
Se explicó la importancia de la "capa semántica" para llegar a la base de datos o fórmula de cálculo correctas.
Sobre la capa semántica, percibí que en las charlas posteriores se mencionó con frecuencia, lo que confirma que su nivel de interés sigue creciendo.
◼︎Casos de uso de análisis de datos
Lion Corporation presentó sobre la construcción de infraestructura de datos, y Mercari, Inc. compartió sus iniciativas para democratizar los datos.
La democratización de los datos me resultó especialmente memorable, ya que es un tema cercano a nuestro día a día. La creación de un entorno en el que cualquiera pueda acceder a los datos, un ámbito antes reservado a los analistas, mediante la incorporación de agentes de IA, es algo que nos gustaría tomar como referencia.
En la sesión de intercambio interna que realizamos posteriormente, comentamos que queríamos incorporar estas ideas de inmediato.
◼︎Demostración pública de análisis conversacional
Se presentó una demostración de un agente de análisis conversacional, tomando como ejemplo "Conversation analytics agent in BigQuery".
Aunque ya había usado BigQuery de forma básica, desconocía que permite realizar análisis de datos en lenguaje natural, así que fue una auténtica revelación. Las funciones de apoyo son muy completas, como la mejora de la precisión de los datos mediante las sugerencias de Gemini o la generación automática de consultas doradas, y me llamó la atención lo relativamente sencillo que resulta la configuración.
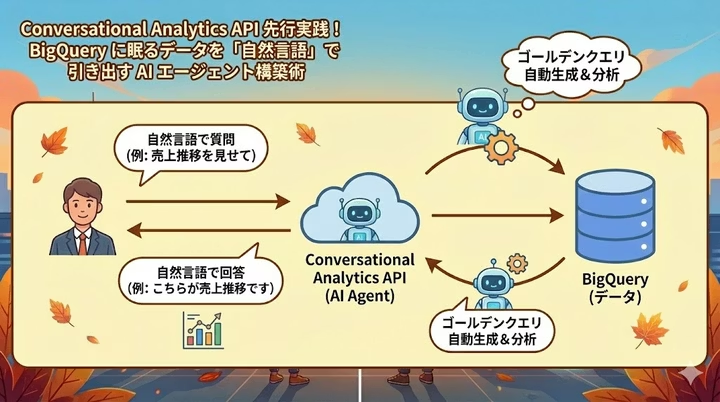
Primeras prácticas con la Conversational Analytics API: cómo crear un agente de IA que extrae datos almacenados en BigQuery mediante lenguaje natural
En una presentación de Eyelet Inc., se expuso un caso de análisis de datos en formato de chat que combina BigQuery y la Conversational Analytics API.
El contenido consistía en acumular los datos del sitio en BigQuery y delegar por completo en la Conversational Analytics API la ejecución de consultas y las tareas de análisis. Al permitir acceder a agentes de IA desde las herramientas de comunicación que se usan a diario, se había creado un entorno en el que cualquier persona puede aprovechar los datos con facilidad.
Era un contenido que encarnaba precisamente la "democratización de los datos" mencionada en la conferencia magistral, y su estructura resultaba muy sencilla. Pensé que nuestra empresa también debería adoptarlo cuanto antes.
Me encantaría implementarlo yo mismo, pero considerando mis habilidades actuales, probablemente me llevaría años. Así que prefiero confiárselo a los ingenieros de nuestra empresa.
Pocos pasos: agente de IA con integración de Google Trends y colaboración con el maestro de productos
En una charla de AONE Smart Technology Inc., se presentó un caso práctico, propio de empresas con tiendas físicas, sobre cómo aplicar la IA a los "datos maestros de productos".
El tema de la presentación abordó dos desafíos: "la eliminación de la búsqueda ambigua" y "la coincidencia automática con las tendencias". Ambos contenidos se basaban en una arquitectura que utiliza "Google Vertex AI Search".
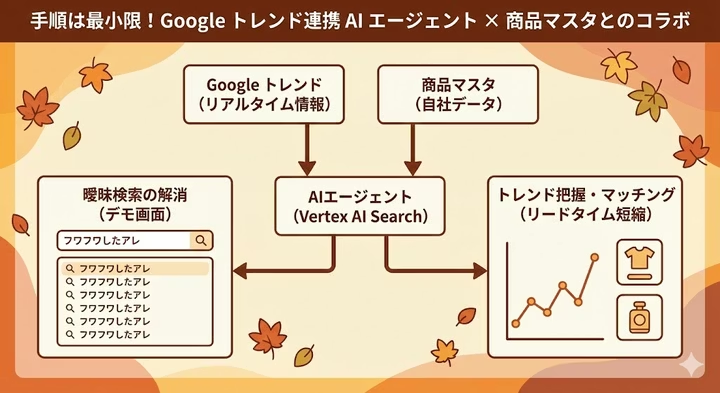
— Búsqueda ambigua en el maestro de productos mediante IA
Como problema característico de las empresas con tiendas físicas, se ejemplificaron preguntas ambiguas de clientes que no incluyen nombres concretos de productos. Los sistemas tradicionales exigen una "coincidencia exacta", por lo que preguntas que una persona responde fácilmente se convierten en un gran obstáculo para el sistema. Se presentó un enfoque basado en IA para abordar este desafío.
En la demostración se presentó un sistema que, incluso ante consultas ambiguas como las de una búsqueda en internet, devuelve de inmediato información de productos adecuada a partir de big data. No llegué a entender bien el funcionamiento, pero me quedé completamente impresionado de que una empresa pueda llegar tan lejos.
— Seguimiento de tendencias y emparejamiento automático con datos de productos
La charla trató sobre la evaluación de herramientas que capturan de inmediato información de tendencias externas y la vinculan automáticamente con los datos de productos internos, con el objetivo de acortar el tiempo que transcurre desde que surge una necesidad del cliente hasta que el producto llega a la tienda.
Fue una charla sobre tecnología de vanguardia y resultó muy interesante. Todavía no me imagino cómo podríamos aprovecharla en nuestros servicios, pero personalmente me gustaría probar "Google Vertex AI Search".
Conclusión
Esta entrada solo recoge las sesiones que más me impactaron. ¿Qué les parece? Espero que haya podido transmitir, aunque sea en parte, la emoción que sentí con "la innovación que traen los agentes de datos".
Para ser sincero, con el uso de datos íbamos avanzando a un ritmo bastante pausado, pero participar en esta cumbre fue una oportunidad excelente que me hizo pensar: "¡Tenemos que ponernos en marcha de verdad para no quedarnos atrás en esta ola!".
Para empezar, quiero comenzar por la "definición de datos y de la capa semántica", que se insistió una y otra vez en lo importante que es.



Director web con una trayectoria ascendente desde su ingreso como recién graduada, actualmente en plena dedicación. Aspira a convertirse en una profesional polivalente que domine todos los ámbitos, desde el diseño hasta la gestión de publicidad, y afronta nuevos retos cada día. En el trabajo busca una dirección ágil y eficaz, mientras que en su vida personal disfruta de una vida de retiro en su propia fortaleza: su hogar. Le gusta el anime.
Handan-chan
Director web / Incorporación en 2022