

Liberogic 正在調整自家網站,使其更易於 AI 代理與 LLM 讀取與理解。
除了搜尋引擎之外,Claude、Gemini、ChatGPT 等 LLM 與 AI 代理讀取網站、整理資訊、進行比較,甚至代替使用者進行調查的情境,如今已變得司空見慣。
Liberogic 的網站也正為了讓 AI 能夠讀取而做準備,包括 robots.txt、sitemap、Link headers、llms.txt,以及為每篇文章生成 Markdown 檔案等。
本文將介紹 Cloudflare 上週公開的 「Is Your Site Agent-Ready?」 相關內容。
以 Content Site 進行檢查
Liberogic 的網站是企業官網與內容網站,刊登公司資訊、服務介紹、新聞、專欄及案例研究等內容。它不是電商網站,也不是需要 OAuth 認證的 API 應用程式。
因此,檢查時的網站類型應選擇 「Content Site」。
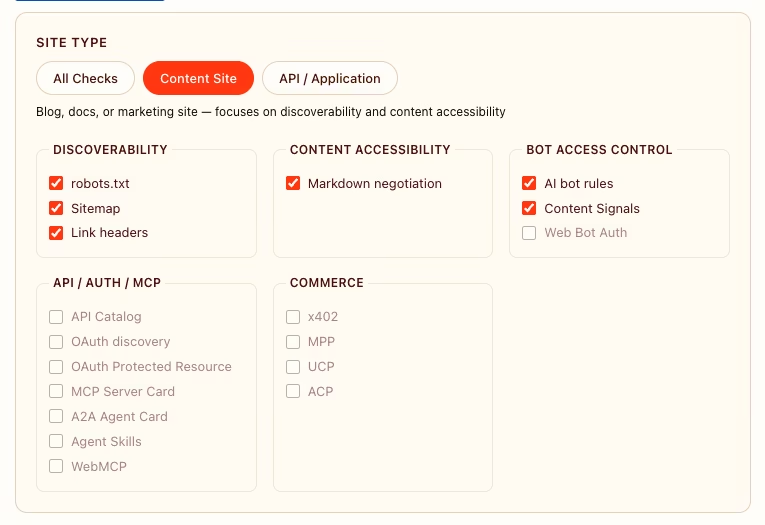
本次評估不包含 Commerce、API / Auth / MCP 相關項目,主要從以下角度進行確認。
- Discoverability
- Content Accessibility
- Bot Access Control
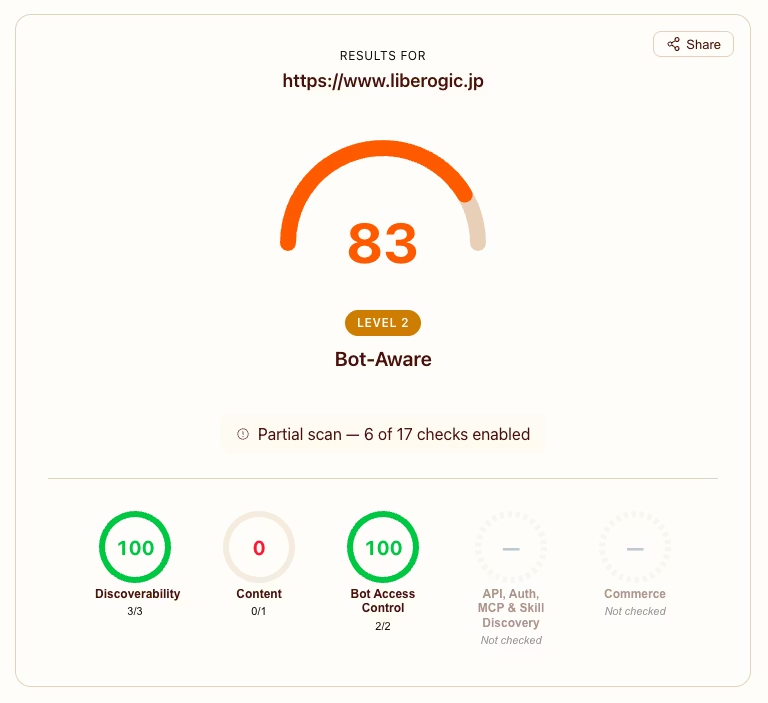
結果……分數為 83 分,Level 2「Bot-Aware」😭
為什麼不是 100 分呢!!
立即驗證 / 確認
本次檢查中,Discoverability 得分為 100 分,Bot Access Control 也得到 100 分。
robots.txt、sitemap、Link headers、AI bot rules、Content Signals 等項目均已完成對應,AI bot 能夠發現網站並理解存取政策的基本導引已建置完成。
簡單來說,
- 讓對方發現網站的存在
- 告訴對方內容位於何處
- 向 bot 說明存取政策
- 發出 AI 專用信號
等部分已完成對應。
另一方面,「Content Accessibility」項目的得分為 0 分 (TT)
單看這一項,可能會覺得「咦,內容無法被讀取嗎?」,但實際情況並非如此。
Markdown 內容本身已經準備就緒。
Liberogic 網站已依一定比例,為文章內容與案例研究產生便於 AI 讀取的 Markdown 格式檔案。
文章與案例研究都確實有對應的 Markdown 檔案,每個頁面的 head 內也設定了指向 Markdown 版內容的 link 標籤,並提供實際 AI 代理能夠找到 Markdown 檔案的路徑。
並非未支援 Markdown,而是以 LLM 易於讀取的形式提供內文,因此不屬於「尚未準備好讓 AI 讀取」的狀態。
那麼為什麼無法拿到 100 分呢 👺
這次未能拿到 100 分,並非因為網站端什麼都沒做,而是目前的實作架構與檢查工具的判定規格之間不相容所致。
Liberogic 網站以 Astro 的 SSG 實作,並在預覽頁面中使用 SSR,形成混合式架構。
Markdown negotiation 通常會在中介軟體 (middleware) 中處理,但由於採用混合架構,我們使用了 Cloudflare 介接器 (adapter),而其輸出的 _worker.js 會優先執行。因此中介軟體無法載入,導致檢查工具無法辨識 Markdown negotiation。
實際上網站確實有 Markdown 檔案,也能從 head 內的 link 標籤存取,但檢查工具卻判定「無法確認 Markdown negotiation!」,這是當時的情況。
可惡!做得不夠徹底啊!
雖然很想這樣抱怨……但我們當然每天都承蒙 Cloudflare 的照顧。
也感謝您核准合作夥伴認證。
不過,一直以來都在追求 Lighthouse 滿分的我們,對這點還是有些不甘心。
要達到 100 分是可能的!但我們不想為了分數而犧牲營運效率,也不想增加額外成本。
針對此問題,我們想到了幾種可能的做法。
- 另外建置 Cloudflare Workers,專門處理 Markdown 回傳
- 將預覽頁面改為 CSR,並採用完整的 SSG 架構
- 將 Cloudflare 的服務方案升級為商業方案,並使用 Transform Rules 改寫 URL
等方法。
沒錯,只要將 Cloudflare 的服務升一個等級,確實可以讓檢測工具上的評分接近 100 分。
不過就目前而言,為此單獨增加費用的決定有點微妙呢!
我們的目標並非在檢測工具中拿滿分,而是讓 AI 代理與 LLM 能夠正確讀取 Liberogic 網站上的資訊。從 LLM 讀取內容的角度來看,我們認為本公司所需的對應工作已相對進展良好。
與其為了拿到 100 分而增加成本,不如確保內容能被確實讀取。
並且能穩定營運。
Liberogic 認為,維持這種平衡非常重要。
也別忘了 llms.txt!
雖然本次檢查項目並未包含此項,但 Liberogic 同樣支援 /llms.txt。
llms.txt 是一種類似目錄的檔案,用來告訴 LLM「這個網站有哪些資訊,應該閱讀哪些頁面」。
這個概念與搜尋引擎用的 sitemap.xml 相近,但更偏向 LLM,主要功能是整理網站的概要,並引導至重要內容。
檢查工具的檢查項目中並未包含此項,但 Cloudflare 重視資料品質,也就是「能否以低雜訊取得內文(是否已轉為 Markdown)」,因此或許是刻意不納入。
直接讓它讀取 HTML 就可以了嗎?
讓 AI 代理讀取網站時,當然也可以直接讓它解析 HTML。
不過實際的網頁包含了導覽列、標頭、頁尾、裝飾性元素,以及由 JavaScript 控制的部分等大量與內文無關的資訊。即使頁面看起來很自然,對 LLM 而言往往雜訊很多。
若硬要將複雜的 HTML 轉換為 Markdown,標題結構、清單與表現意圖可能會遭到破壞,結果反而可能產生對 LLM 來說也難以閱讀的資料。
這些問題或許很快就會隨著 AI 的進步而改善,但我認為現階段最重要的是逐一完成眼前需要做的事。各位的網站目前進展到什麼程度了呢??



身為社長,卻始終站在第一線。理解新技術,當某件事變得更方便的那一刻就會感到喜悅,並全心投入。對未來的技術充滿期待,無論年紀多大,都想享受新的體驗。
森本 忠典
專案經理 / 導演 / 2007 年創立