

Liberogic 正在推进相关工作,使我们自己的网站结构也便于AI智能体和LLM读取。
如今,除了搜索引擎之外,Claude、Gemini、ChatGPT等LLM和AI智能体读取网站、整理和比较信息,并代替用户进行调研,已成为司空见惯的场景。
Liberogic 的网站也在为被AI读取做准备,包括 robots.txt、sitemap、Link headers、llms.txt,以及为每篇文章生成 Markdown 文件等。
本文将介绍 Cloudflare 上周发布的《Is Your Site Agent-Ready?》相关内容。
以 Content Site 进行检查
Liberogic 的网站是企业官网和内容网站,刊载公司信息、服务介绍、新闻、专栏和案例研究等内容。它不是电商网站,也不是需要 OAuth 认证的 API 应用。
因此,在检查时我们选择的网站类型为 “Content Site”。
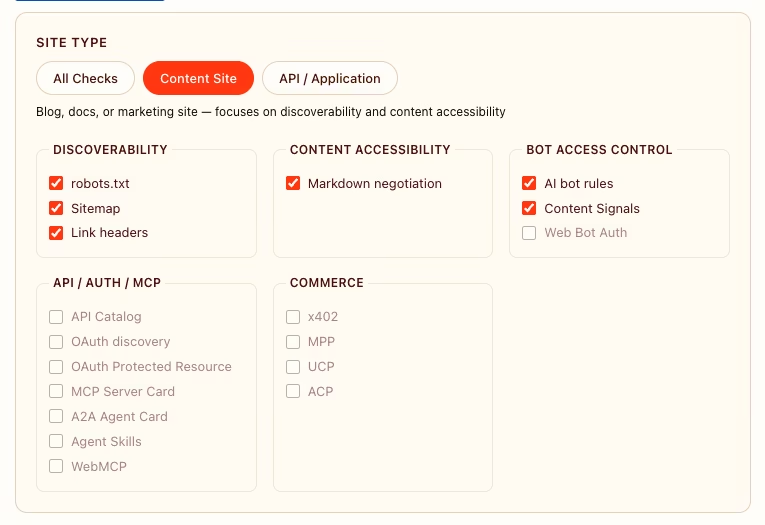
本次评估不包括 Commerce、API / Auth、MCP 相关项目,主要从以下角度进行检查。
- Discoverability
- Content Accessibility
- Bot Access Control
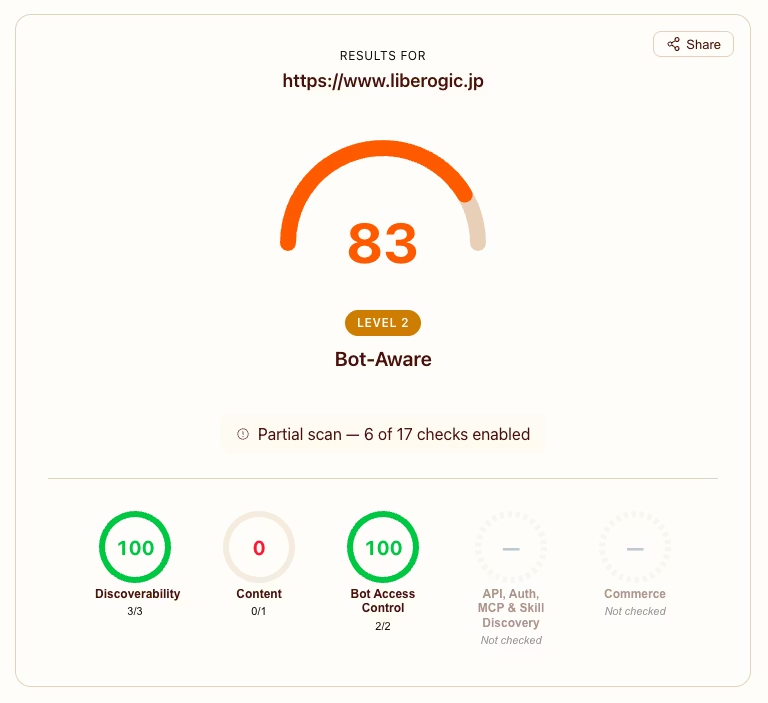
结果……得分为 83 分,Level 2「Bot-Aware」😭
为什么不是100分呢!!
马上验证 / 确认
本次检查中,Discoverability 得分为 100 分,Bot Access Control 也得到了 100 分。
robots.txt、sitemap、Link headers、AI bot rules、Content Signals 等项目均已完成配置,AI bot 能够发现网站并理解访问策略的基本路径已经搭建完成。
简单来说,
- 让对方发现网站的存在
- 告知内容所在位置
- 向 bot 说明访问策略
- 发出面向 AI 的信号
这些部分属于已达标的内容。
另一方面,Content Accessibility 项目得分为 0 分(TT)。
仅看这一点,可能会让人觉得“咦,内容读不出来吗?”,但实际情况有所不同。
Markdown 内容本身已经准备就绪。
Liberogic 网站已按一定比例为文章内容和案例研究生成了便于 AI 读取的 Markdown 格式文件。
文章和案例研究都有对应的 Markdown 文件,每个页面的 head 中也设置了指向 Markdown 版内容的 link 标签,并提供了让 AI 智能体能够找到 Markdown 文件的导航路径。
这并不是说不支持 Markdown,而是以 LLM 易于读取的形式提供正文内容,因此并非“尚未做好让 AI 读取的准备”。
那么为什么没有拿到 100 分呢 👺
这次没有拿到 100 分的原因并不是网站什么都没做,而是当前的实现架构与检查工具的判定规则之间存在不匹配。
Liberogic 网站采用 Astro 的 SSG 方式实现,并在预览页面中使用 SSR,形成混合架构。
通常,Markdown negotiation 的处理会放在中间件中完成,但由于采用混合架构,我们使用了 Cloudflare 适配器,其输出的 _worker.js 会优先执行。因此中间件没有被加载,检查工具也就无法识别 Markdown negotiation 已生效。
实际上 Markdown 文件是存在的,并且可以通过 head 中的 link 标签访问,但检查工具却判定为“无法确认 Markdown negotiation!”,情况就是这样。
可恶!做得这么半吊子!
虽然很想这么吐槽……但我们当然每天都在受 Cloudflare 的照顾。
也感谢您批准我们的合作伙伴认证。
不过,作为一直在追求 Lighthouse 满分的人,这一点还是让人有些不甘心。
要做到满分是可以的!但我们不想仅仅为了分数而牺牲运维效率,也不想花这笔费用。
针对这个问题,我们考虑了几种应对方法。
- 另外部署一个 Cloudflare Workers,专门处理 Markdown 的返回
- 将预览页面改为 CSR,尽量转向完整的 SSG 架构
- 将 Cloudflare 的服务方案升级为 Business 方案,并通过 Transform Rules 重写 URL
等方法。
没错,通过将 Cloudflare 服务升一个档次,确实可以让检测工具上的评分接近 100 分。
不过就目前而言,仅为此额外支付费用的决定还是有些微妙呢!
我们的目的并不是在检测工具中拿满分,而是让 AI 代理和 LLM 能够正确读取 Liberogic 网站上的信息。从 LLM 读取内容的角度来看,我们认为弊公司所需的应对措施已经相对推进到了较为完善的程度。
与其为了拿到 100 分而增加成本,不如确保内容能够被正确读取。
也要确保能够稳定地运营。
Liberogic 希望重视这种平衡。
也别忘了 llms.txt!
虽然本次检查项目中未包含此项,但 Liberogic 也支持 /llms.txt。
llms.txt 是一种类似目录的文件,用于告诉 LLM“这个网站包含哪些信息,应该阅读哪些页面”。
这与搜索引擎使用的 sitemap.xml 思路相近,但其作用更偏向于面向 LLM,用于梳理网站概览以及通往重要内容的导航路径。
检测工具的检查项目中并未包含这一项。不过,Cloudflare 更重视数据质量,即“如何以较低的噪声获取正文内容(是否已转换为 Markdown)”,因此或许是有意未将其纳入检查范围。
直接让 AI 读取 HTML 就可以了吗?
让 AI 智能体读取网站时,当然也可以直接让其解析 HTML。
然而,实际的网页中包含大量正文以外的信息,例如导航、页眉、页脚、装饰性元素以及 JavaScript 控制等。即使页面看起来很自然,对 LLM 而言往往也会包含大量噪声。
如果强行将复杂的 HTML 转换为 Markdown,标题结构、列表以及表达意图可能会被破坏,最终导致数据对 LLM 而言也难以理解。
虽然这些问题或许会随着 AI 的发展而逐步改善,但我认为当下最重要的是逐一落实当前所需的工作。大家的网站目前在相关方面进展到什么程度了呢??



身为社长,同时也始终是一线的参与者。热衷于理解新技术,在某些事物变得更加便利的瞬间感到喜悦,并全情投入其中。对未来的技术充满期待,无论年龄多大,都希望持续享受全新的体验。
森本 忠典
项目经理 / 总监 / 2007年成立