
Wir haben dies auf unserer eigenen Website umgesetzt, die aus Astro SSG und einem Headless CMS besteht.
Die Einrichtung selbst war recht einfach, doch da unsere Website mehrsprachig aufgebaut ist, gab es einige Stolpersteine.
Was ist Cloudflare AI Search?
Der frühere Name lautete AutoRAG; im September 2025 wurde er umbenannt. Viele Artikel in den Suchergebnissen beziehen sich noch auf den alten Namen und die alte API, daher ist hier Vorsicht geboten.
Dies sind die Schritte, die übernommen werden.
Crawling → Umwandlung in Markdown → Aufteilung in Chunks → Einbettung → Aufbau eines Vektor- und Keyword-Index
Die API bietet zwei Varianten. Die eine gibt eine Liste der Suchergebnisse zurück (search), die andere generiert mit RAG eine Antwort (chat/completions). Wir verwenden in diesem Beitrag nur die erste.
Wichtige Konfigurationspunkte
Erstellen Sie die Instanz wie folgt.
- Wählen Sie als Datenquelle WebCrawl aus
- Öffentliche URL als Crawl-Ziel
- Analysetyp: Sitemap
- Content-Selektor: main-Element angeben
- Analysemodus: Statische Website
- Bestimmte Sitemap angeben: sitemap.xml
- Setzen Sie als Embedding-Modell
@cf/baai/bge-m3(da es sich um eine japanische Website handelt).
Ansonsten sind die Standardeinstellungen in der Regel problemlos.
Authentifizierung und Umgebungsvariablen
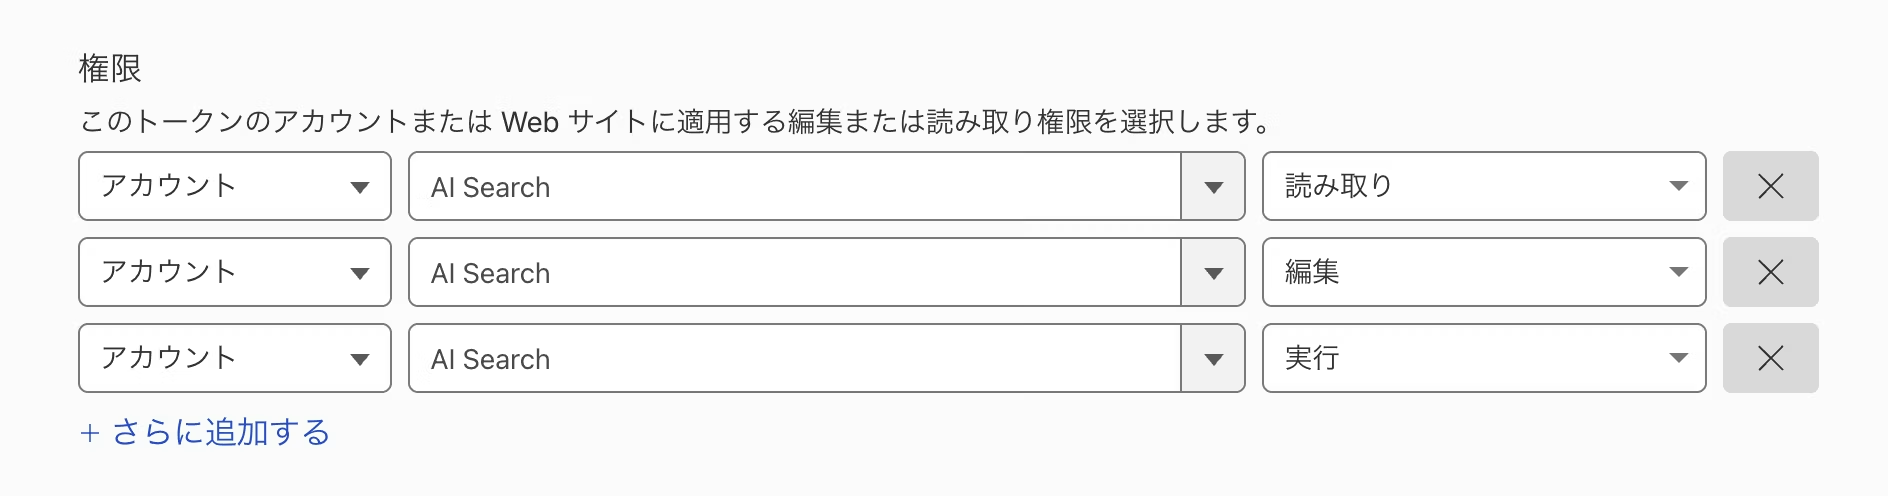
Erstellen Sie ein API-Token über Ihr Konto.
Zu beachten ist, dass nicht nur "AI Search: Lesen" erforderlich ist, sondern auch "Bearbeiten" und "Ausführen".
Das erstellte Token wird über die Umgebungsvariable AI_SEARCH_TOKEN eingelesen.
Aufbau: 1 API-Route + 1 Komponente
Die Suche ruft über eine API-Route von Astro (die als Pages Function läuft) die REST API auf. Da sich das API-Token nicht im Browser offenlegen lässt, ist ein serverseitiger Proxy zwingend erforderlich. Da Pages Functions keine Bindung für AI Search bieten, wird statt des SDK ein einfacher fetch-Aufruf verwendet.
// Astro の API ルート(Pages Functions として動く)
const res = await fetch(
  `https://api.cloudflare.com/client/v4/accounts/${id}/ai-search/instances/${name}/search`,
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}` },
    body: JSON.stringify({
      query,
      ai_search_options: {
        retrieval: {
          retrieval_type: 'hybrid',
          max_num_results: 50
        },
      },
    }),
  }
);
Umgesetzt wurden lediglich zwei Dateien: eine API-Route und eine Such-UI-Komponente. Als nachträgliche Ergänzung zu einer SSG-Website hielt sich der Aufwand damit in engen Grenzen.
Auf mehrsprachigen Websites die Suche auf die angezeigte Sprache beschränken
Bei einer gewöhnlichen Website-Suche reicht das aus. Bei mehrsprachigen Websites liest die Suche jedoch die sitemap.xml mit allen Sprachen aus, sodass sich Ergebnisse aus unterschiedlichen Sprachen vermischen.
Die Lösung besteht darin, ein benutzerdefiniertes Metadatum locale zu definieren und bei der Suche mit filters darauf zu filtern. Dadurch werden nur noch Ergebnisse in der aktuell angezeigten Sprache ausgegeben.
Hinweis: Die Sprache lässt sich weder über das lang-Attribut im HTML noch über og:locale zuverlässig bestimmen, daher ist hier Vorsicht geboten.
<meta name="locale" content="ja_JP">
SEO-Sitemap und Such-Sitemap trennen
AI Search (Website-Datenquelle) crawlt über die Sitemap.
Die öffentliche Sitemap unserer Website hatte jedoch aus SEO-Gründen einige Sprachen bewusst ausgeschlossen. Die Folge: In diesen Sprachen lieferte die Suche stets 0 Ergebnisse.
Da die Sitemap mit @astrojs/sitemap generiert wird, habe ich mich für einen Ansatz entschieden, bei dem eine separate Sitemap mit allen Sprachen für die Suche ausgegeben wird.
Wie die Suchergebnisse angeordnet werden
Das weicht ziemlich von der Vorstellung ab, die man beim Begriff "AI-Suche" hat.
AI Search teilt japanischen Text in Abschnitte (Chunks) von etwa 300 bis 450 Zeichen auf.
Bis zu 50 passende Chunks werden ausgewählt, und die Seiten, die diese enthalten, erscheinen als Ergebnisse.
Seiten mit Chunks, die als besonders relevant eingestuft wurden, stehen weiter oben. Da mehrere Chunks von einer einzigen Seite stammen können, fällt die Anzahl der Suchtreffer niedriger aus als 50.
Die Zusammenführung der Ergebnisse auf Seitenebene erfolgt im Frontend. Bei diesem gesamten Ablauf wird übrigens kein einziges Mal generative KI ausgeführt.
Fazit
Voraussetzung für den Einsatz ist, dass die DNS-Zone der Domain bei Cloudflare liegt und der Betrieb über Pages / Workers erfolgt. Die Implementierung ist jedoch unkompliziert, und für eine einfache Website-Suche dürfte sie sehr gut geeignet sein.
Umgekehrt gilt: Wenn man die Suche nachträglich hinzufügen möchte, ohne die Infrastruktur anzufassen, oder wenn alle Inhalte aufgelistet werden sollen, oder wenn Verwaltungsfunktionen für Betreiber wie Suchprotokoll-Analysen, Vorschläge und Synonymwörterbücher benötigt werden, ist das klassische ASP-basierte Modell klar im Vorteil.
Für ein ASP ist der Aufwand allerdings zu hoch, die Suche wird aber dennoch gewünscht. Für Websites dieser Größenordnung ist dies meiner Ansicht nach eine sehr passende Option.



Vom DTP in die Webwelt: Heute beherrscht er Markup, Frontend, Projektleitung und Barrierefreiheit gleichermaßen – ein wahrer "Techniker-Guru". Seit den Anfängen von Liberogic vielseitig im Einsatz und heute eine lebende Enzyklopädie im Team. Derzeit tüftelt er mit großer Begeisterung an effizienteren Abläufen durch gezielte Prompts – etwa mit der Frage: "Können wir bei der Barrierefreiheit nicht mehr auf KI setzen?" Technik und Denkweise entwickeln sich weiter.
Ayumu Futamata
IAAP-zertifizierter Web Accessibility Specialist (WAS) / Markup-Entwickler / Frontend-Entwickler / Webdirektor