

アプリケーション側では、何をどこまで記録するべきか
こんにちは、リベロジックでCTOをしている大塚です。
前回は、AWS、Cloudflare、Vercel、Supabase、ヘッドレスCMSなど、サービスごとのログ機能を比較しました。
各サービスには実行ログやエラーログ、管理操作の記録などが用意されています。
では、それらを組み合わせれば、Webサービスに必要なログはすべてそろうのでしょうか。
残念ながら、そう簡単ではありません。
クラウドサービスが自動的に残してくれるログと、自分たちが作るアプリケーション側で記録しなければならないログは別だからです。
今回は、実際のWebサービスでログ設計をどのように考えるのか、実務に近いところを整理してみます。
サービス側のログだけでは分からないこと
Cloudflare WorkersやVercel Functionsを使っていれば、処理の実行結果やエラーはある程度自動的に記録されます。
Supabaseであれば、データベースや認証、APIなどのログを確認できます。
ただし、サービス側が把握できるのは、あくまでそのサービス内で起きたことです。
自動的に残りやすいもの | アプリ側で記録するもの |
|---|---|
WorkerやFunctionの実行 | 問い合わせの受付 |
例外や処理エラー | 会員情報の変更 |
APIのレスポンス | 権限の変更 |
データベースへの接続 | メール送信処理の成否 |
クラウド環境の管理操作 | スパム判定や業務上の拒否 |
例えば、データベースへの書き込みが成功したことは分かっても、それが「問い合わせを受け付けた」のか「会員情報を変更した」のかまでは分かりません。
こうした業務上の出来事は、アプリケーション側で意味を付けて記録する必要があります。
何でもログに出せばよいわけではない
調査に備えて、できるだけ多くの情報をログに出しておきたい、と考えることもあります。
ただ、ログが多ければ多いほどよいわけではありません。
すべての処理を細かく記録すると、本当に必要な情報が埋もれてしまいます。ログの量が増えれば、保存や検索にかかる費用も増えていきます。
そのため、私たちは処理の「境界」を意識してログを設計します。
例えば問い合わせフォームであれば、
- 受付に成功した
- 入力内容に問題があり拒否した
- スパム判定で拒否した
- データベースへの保存に失敗した
- 通知メールの送信に失敗した
といった、処理の結果が変わるポイントを記録します。
途中の細かな変数や処理をすべて残すのではなく、あとから経緯を追うために必要な出来事を選ぶイメージです。
ログは文章ではなくデータとして残す
ログには、単に「エラーが発生しました」と書くよりも、あとから検索できる情報を含めておくほうが便利です。
項目 | 役割 |
|---|---|
発生日時 | いつ起きたかを確認する |
イベント名 | どの処理で起きたかを分類する |
重要度 | 成功、警告、失敗を分ける |
対象ID | 対象となるデータを特定する |
リクエストID | 一連の処理を追跡する |
処理時間 | 遅延や性能低下を確認する |
こうした項目を決まった形式で記録するものを、構造化ログと呼びます。
JSONのような形式で項目をそろえておけば、「特定の申込IDに関する処理だけを確認する」「エラーになったメール送信だけを抽出する」といった検索がしやすくなります。
個人情報はログへ書かない
問い合わせフォームのログを残すとき、氏名、メールアドレス、問い合わせ本文まで記録してしまうケースがあります。
調査には便利そうですが、これは避けたほうがよい設計です。
ログへ書く | ログへ書かない |
|---|---|
処理日時 | パスワード |
イベント名 | アクセストークン |
成功・失敗 | Cookie |
対象データのID | 問い合わせ本文 |
リクエストID | クレジットカード情報 |
処理時間 | 不要な個人情報 |
ログは複数のサービスへ転送されたり、長期間保存されたりします。その中に個人情報や認証情報が含まれていると、ログ自体が新しい情報漏えいの原因になります。
問い合わせ内容のような業務データはデータベースへ保存し、ログには問い合わせを識別するIDと、受付に成功した事実だけを記録します。
必要になったときは、そのIDを使ってデータベース側の情報と突き合わせます。
問い合わせフォームで考える
問い合わせフォームでは、通知メールを送るだけの構成をよく見かけます。
ただし、メールは送信処理が成功しても、相手に必ず届くとは限りません。
そのため、問い合わせ内容は先にデータベースへ保存し、メールは担当者への通知として扱うほうが安心です。
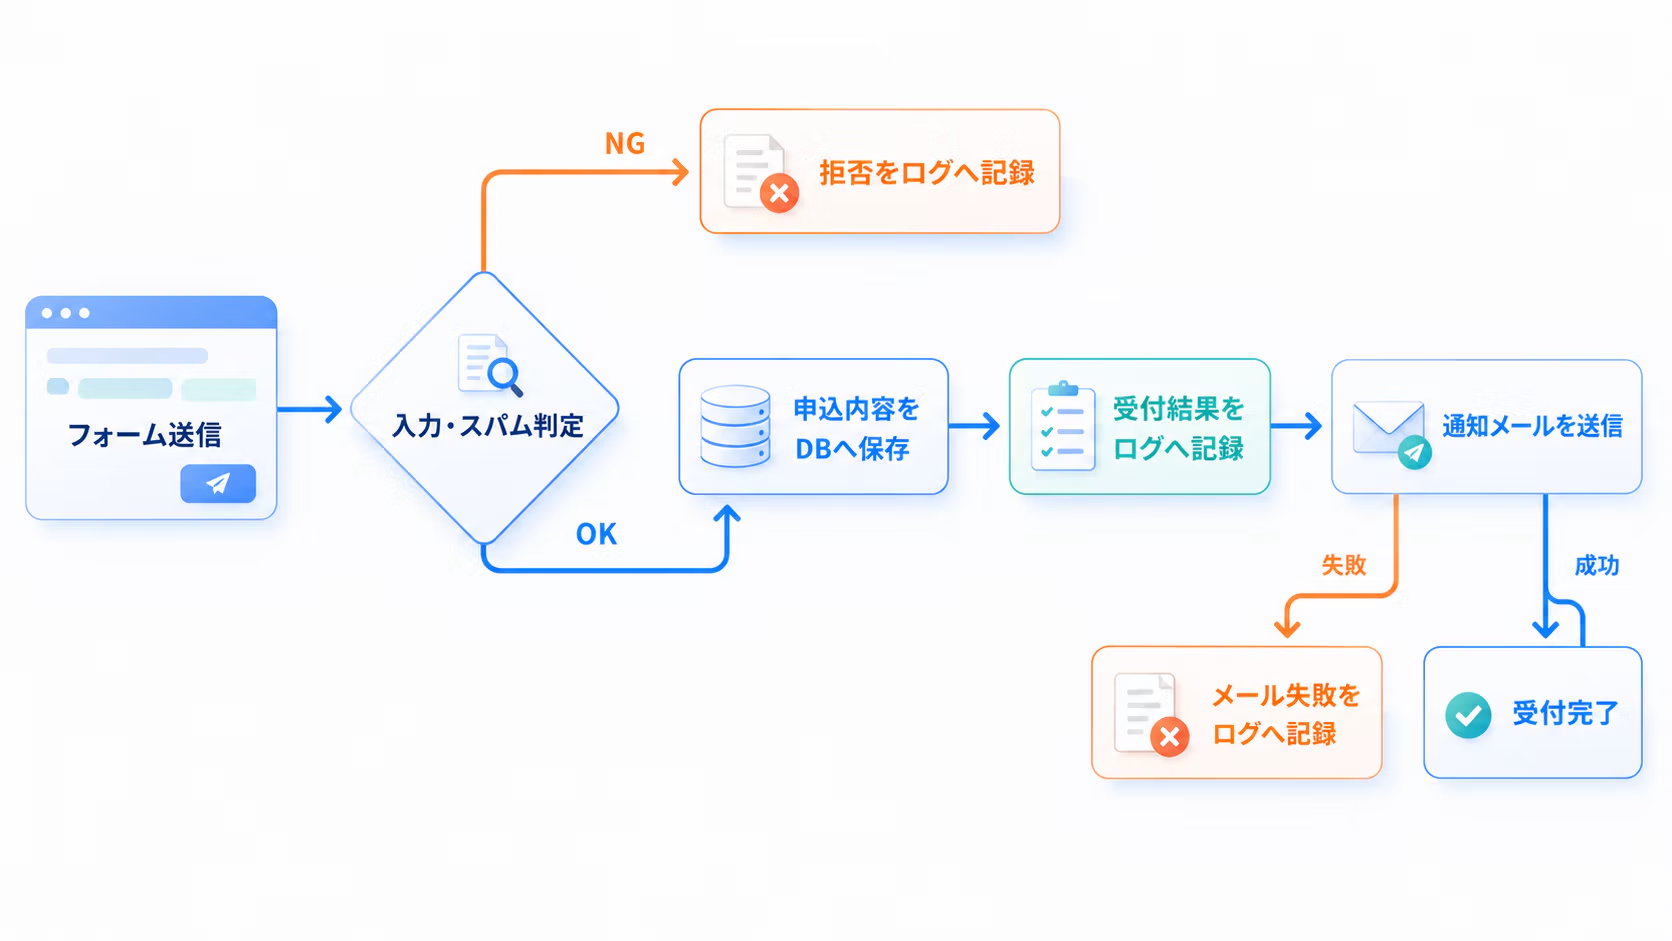
この構成なら、「問い合わせ自体が届いていない」のか、「問い合わせは保存されているが通知メールだけ失敗した」のかを切り分けられます。
こういう地味な違いが、実際の問い合わせ対応ではとても重要なんですよね。
短期の検索と長期の保存を分ける
日常的な障害調査では、直近のログをすぐ検索できることが重要です。
一方、監査やインシデント調査のためのログは、普段はほとんど見なくても、数か月後や数年後に取り出せることが重要になります。
保存先 | 主な目的 |
|---|---|
各サービスのログ画面 | 直近の動作確認 |
Datadogなどのログ管理サービス | 横断検索、監視、通知 |
R2やS3 | 長期間の証跡保管 |
直近の調査に必要なものは検索しやすい場所へ置き、長期的な証跡は安価な保存先へ移す。
シンプルですが、実務ではこの分け方がかなり効いてきます。
ログとダッシュボードも別のもの
ログがあれば、アクセス数やエラー率などもすべて分かるように思えます。
ただし、ログとダッシュボードで見る数値は、少し役割が違います。
- ログ:一件ずつの出来事を詳しく調べる
- メトリクス:件数、割合、処理時間などを集計する
- ダッシュボード:システム全体の傾向を把握する
日常的な状態確認はダッシュボードで行い、異常が見つかったらログで詳しく調べる。
この2つを組み合わせることで、運用しやすい状態になります。
最低限決めておきたいこと
最後に、ログ設計で確認しておきたい項目をまとめます。
- 記録するイベント
- ログへ含める項目
- 個人情報や認証情報の除外
- 直近ログを検索できる期間
- 長期保存するログの範囲
- 長期ログの保存先
- ログを閲覧できる担当者
- 保存期間を過ぎたログの削除方法
監査ログという言葉を聞くと、すべての操作を記録し、大きなログ管理基盤を導入しなければならないように感じるかもしれません。
一方、一般的なWebサイトやメディアサイトであれば、まずは重要な操作や処理結果を決め、短期検索と長期保存を分けるところから始められます。
大切なのは、利用しているサービスのログ機能を並べることではなく、システム全体として必要な記録が残っているかを見ることです。
何を残すのか。
何のために残すのか。
どのくらいの期間が必要なのか。
この3つを整理しておけば、必要以上に大きな構成にせず、案件に合ったログ設計がしやすくなります。
ログは普段あまり目立ちません。
でも、何かが起きたときに「何が起きていたのか」を説明できるかどうかは、最初の設計で決まります。
こういう地に足のついたところを、きちんと作っておくことが大事なんですよね。
ではでは。




リベロジック技術部門の屋台骨。「こんなものが欲しいなぁ、あったら便利だよなぁ〜」という言葉を聞くと、持ち前の知恵で付加価値までつけて、あっという間に実装。コミュ力が高くお客様にファンも多い弊社の宝、そして猫大好き人間。
大塚 翔
取締役CTO / チーフエンジニア / 合同会社猫穴代表 / 無駄に若く見える